
 IXThinker·2025-06-05 23:40
熵最小化後訓練新法 僅需1條未標註數據勝過RL
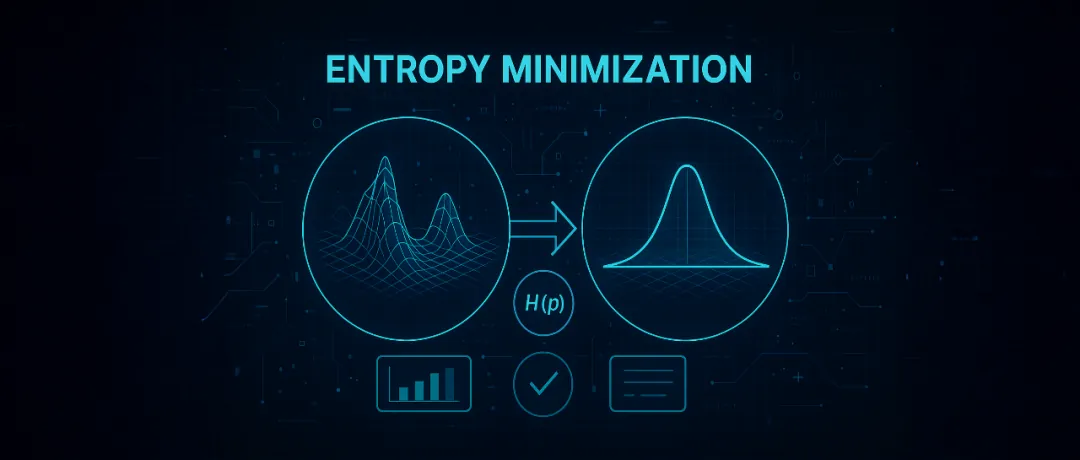
一項新研究提出無監督的熵最小化方法,僅需一條未標註數據與約10步優化,即可顯著提升大模型在數學等推理任務上的表現,效果甚至超越依賴海量數據與複雜獎勵機制的強化學習,後訓練迎來新思路。
後訓練的新思路
當前大模型研究已從追求通用性能,轉向攻克數學推理、物理現象分析、編程邏輯構建等特定且複雜的任務,後訓練階段的優化變得愈發關鍵。
主流做法是採用強化學習,特別是結合可驗證獎勵的訓練方式,但此類方法往往需要大量數據與複雜的獎勵機制,成本與工程門檻均不低。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。