
 IXThinker·2025-06-06 15:50
華為超節點方案 強化學習後訓練提速
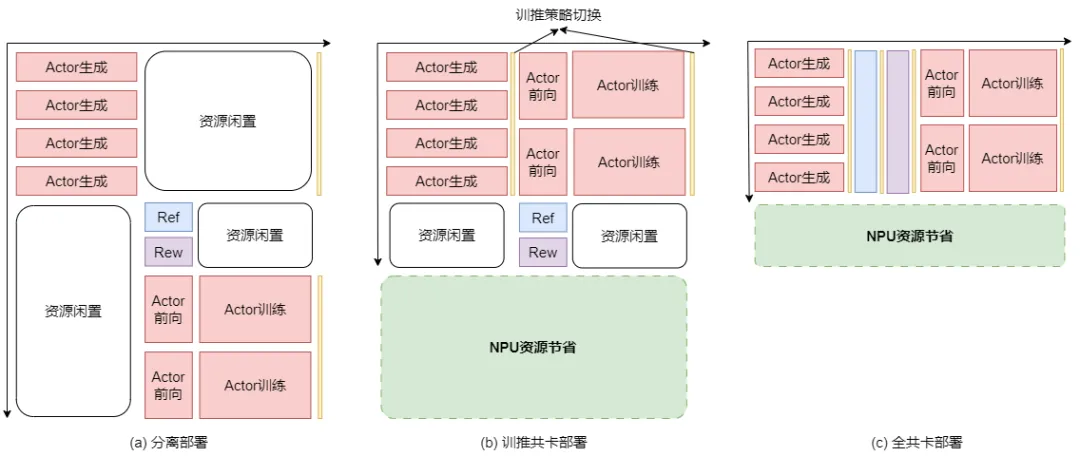
強化學習後訓練已成突破大模型性能天花板的殺手鐧,但算力浪費與集群效率低是一大難題。華為團隊祭出兩項技術破局,令資源利用率翻倍、訓練速度再提升50%。
RL後訓練成殺手鐧
在大模型競賽白熱化之際,強化學習後訓練已成為突破LLM性能天花板的核心路徑,OpenAI o1、DeepSeek-R1等爆火模型背後都依靠它點石成金。相比預訓練廣撒網式獲取知識,RL後訓練驅動模型與外部環境動態交互。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。