
 IXThinker·2025-06-27 23:00
北大學術檢索評測出爐 頂尖模型難以勝任
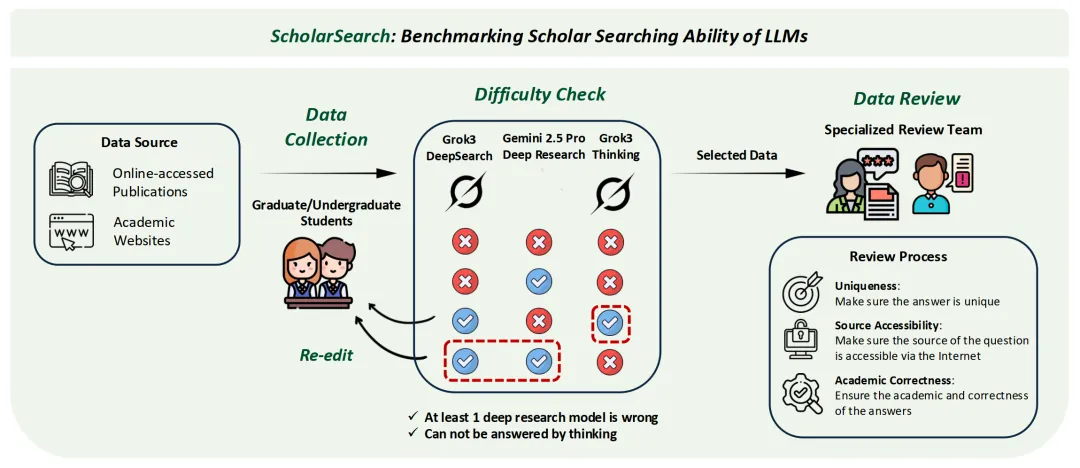
大語言模型能勝任科研助手嗎?北京大學DS-Lab團隊給出一份考卷:首個評測LLM學術複雜資訊檢索能力的數據集ScholarSearch,含223道高難度題目;測試顯示即使頂尖模型也難以勝任,純推理模型準確率普遍低於9%。
首個學術檢索評測
ScholarSearch是首個專門評估大語言模型在學術研究中複雜資訊檢索能力的數據集,包含223道高難度學術檢索題目及其答案,堪稱一場給AI的「開卷考試」,直擊科研輔助的真實能力邊界。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。