
 IXThinker·2025-06-30 16:50
強化學習也能預訓練 伯克利新法遷移能力大增
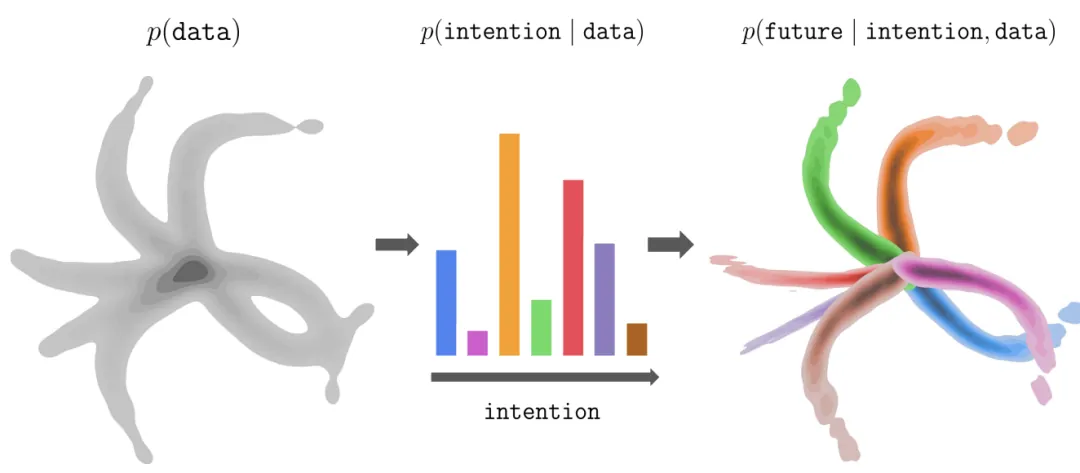
預訓練—微調範式正在改寫強化學習的研究方式。伯克利團隊提出的InFOM無需獎勵訊號即可完成多任務遷移,甚至能做出近乎「讀心術」的推理,引發廣泛關注。
範式移植
大規模預訓練已根本改變機器學習研究:基礎模型只需訓練一次,之後即使缺乏數據或算力,也能在具體任務上直接適配與微調,這種模式在計算機視覺與自然語言處理領域屢試不爽。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。