
 IXThinker·2025-07-03 13:00
單階段監督加強化微調 助大模型推理雙升
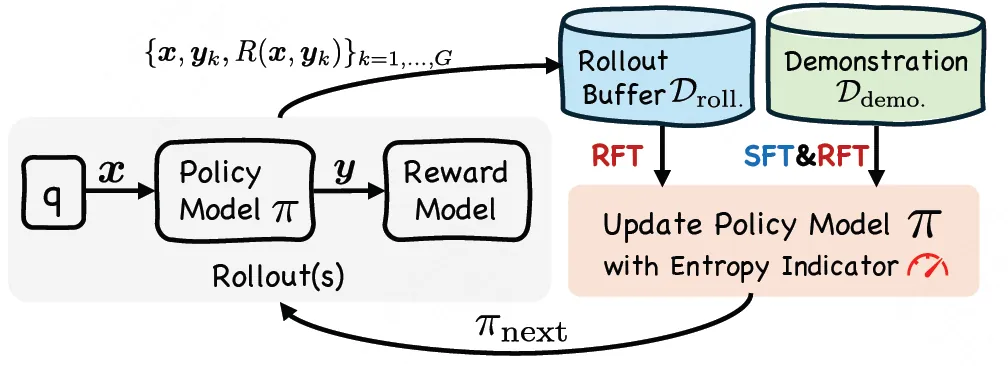
提升大模型推理能力,監督微調與強化微調各有優劣。中科院自動化所深度強化學習團隊聯合美團提出SRFT,讓兩種範式在同一階段協同發力。
傳統困境
以往SFT與RFT多分階段進行,先以專家數據「背書」,再以獎勵信號「刷題」,兩種訓練信號彼此割裂,難以同時兼顧模仿學習與自我探索。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。