
 IXThinker·2025-07-05 13:50
VScan剪冗餘token LVLM推理提速近三倍
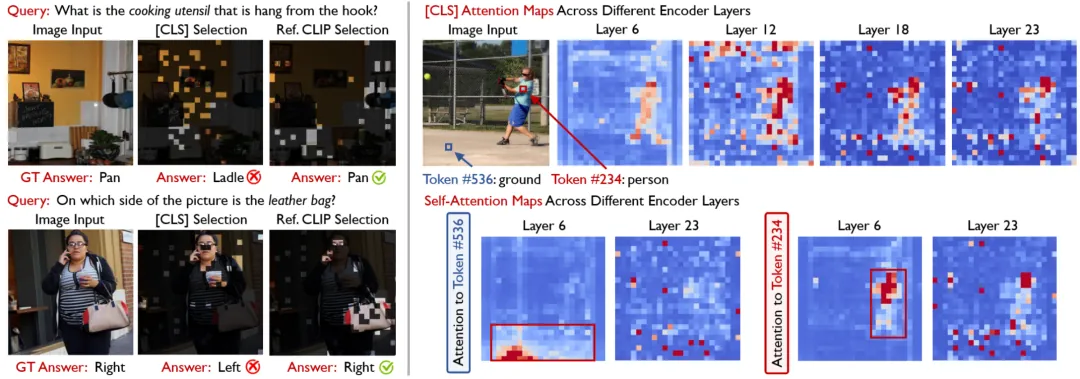
多圖像、長影片、細粒度感知令大型視覺語言模型(LVLM)愈來愈聰明,視覺token數量卻隨之暴增,推理成本急漲。騰訊AI Lab聯同CMU提出VScan,以兩階段視覺token篩選,在幾乎不損性能下實現最高2.91倍推理加速。
視覺token瓶頸
LVLM要處理多圖像、長影片與細粒度感知,變得越來越聰明,卻也越來越「吃不消」:視覺token數量激增帶來的推理成本暴漲,正逐漸成為多模態智能擴展的最大算力瓶頸。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。