
 IXThinker·2025-07-13 13:10
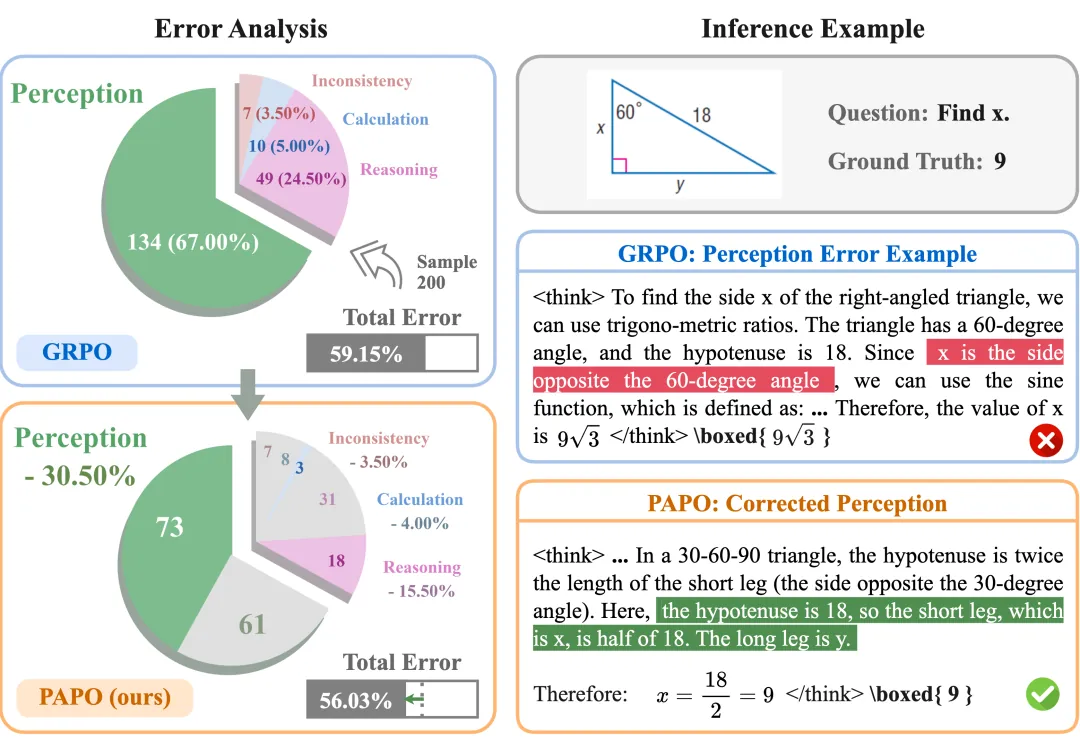
隱式感知損失新算法 感知錯誤率降30.5%
大模型在學習推理的同時,能否也學會感知?伊利諾伊大學香檳分校與阿里巴巴通義實驗室聯合推出多模態推理強化學習算法PAPO,透過隱式感知損失,令模型在推理過程中主動運用視覺資訊。
現有方法短板
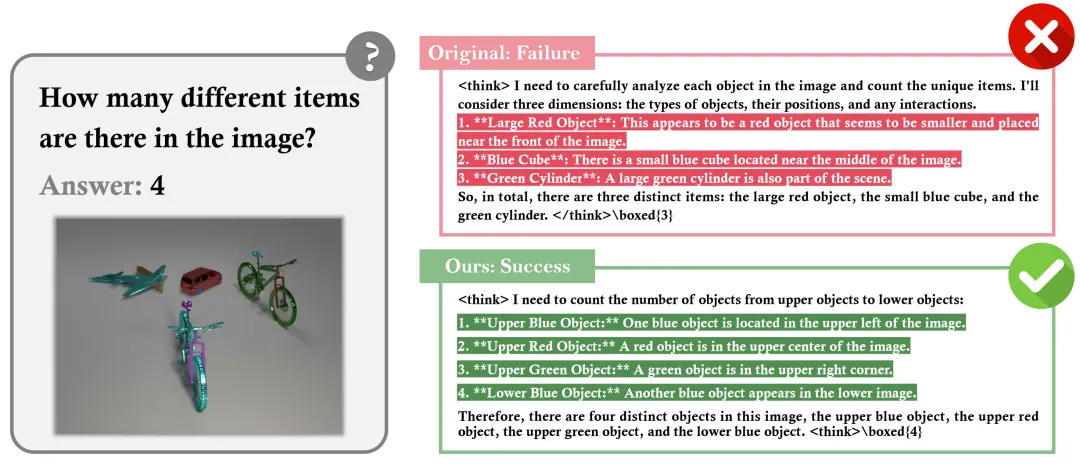
GRPO等現有強化學習算法在純文本推理上表現優異,但套用到多模態場景時,往往無法充分利用視覺資訊,出現未能正確區分物體、計數出錯等感知失誤,直接拖累推理質量。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。