
 IXThinker·2025-07-14 15:00
上海AI實驗室提出獎勵模型擴展新範式
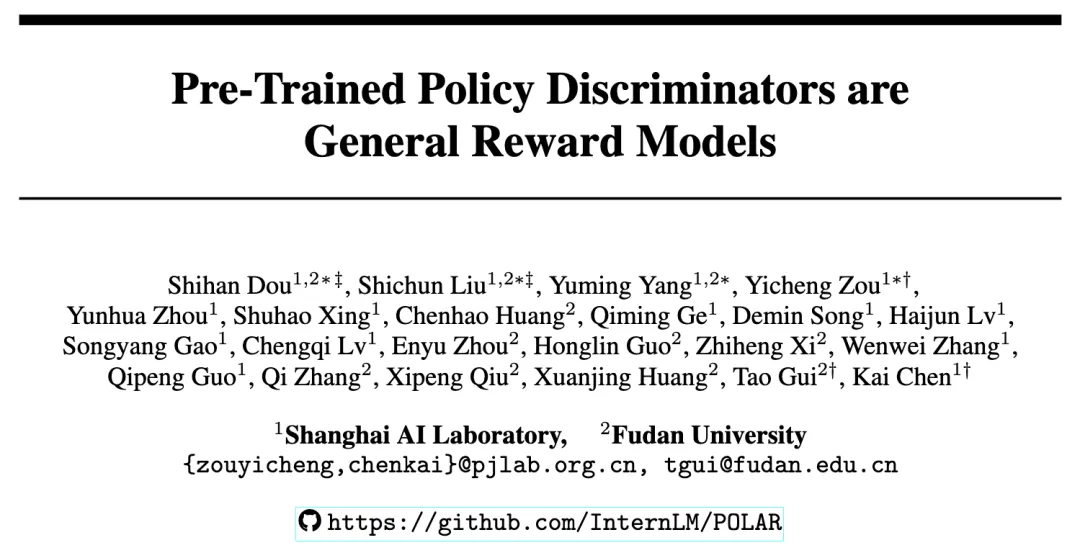
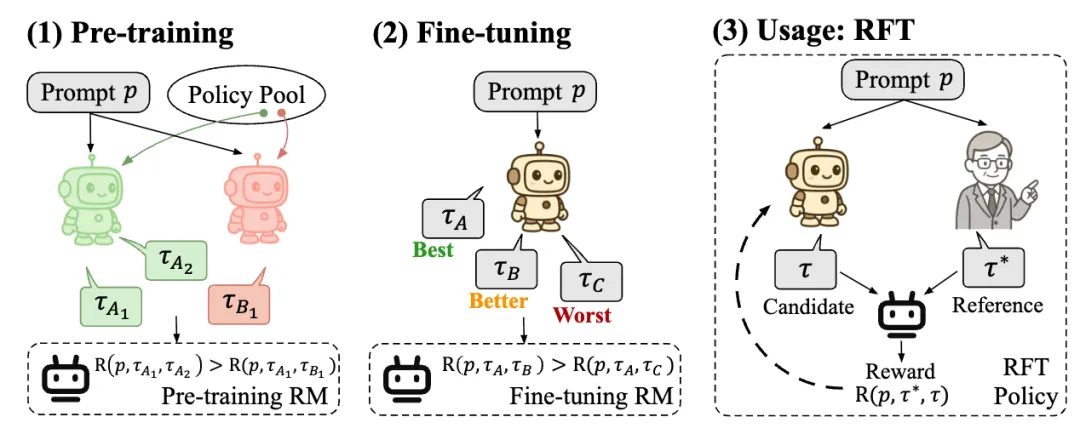
強化學習改變了大語言模型的後訓練範式,成為AI邁向AGI進程的關鍵節點,但獎勵模型的短板制約着整條鏈路的擴展。上海人工智能實驗室研究團隊提出新範式,嘗試讓獎勵模型也能隨算力成長。
瓶頸所在
大模型在Next Token Prediction和Test-time Scaling兩種擴展範式下,靠大規模數據與模型擴展實現能力躍升;但獎勵模型缺乏系統性的預訓練和擴展方法,能力難以隨計算量增長而持續提升。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。