
 IXThinker·2025-07-15 11:50
Karpathy質疑強化學習 提複盤式進化
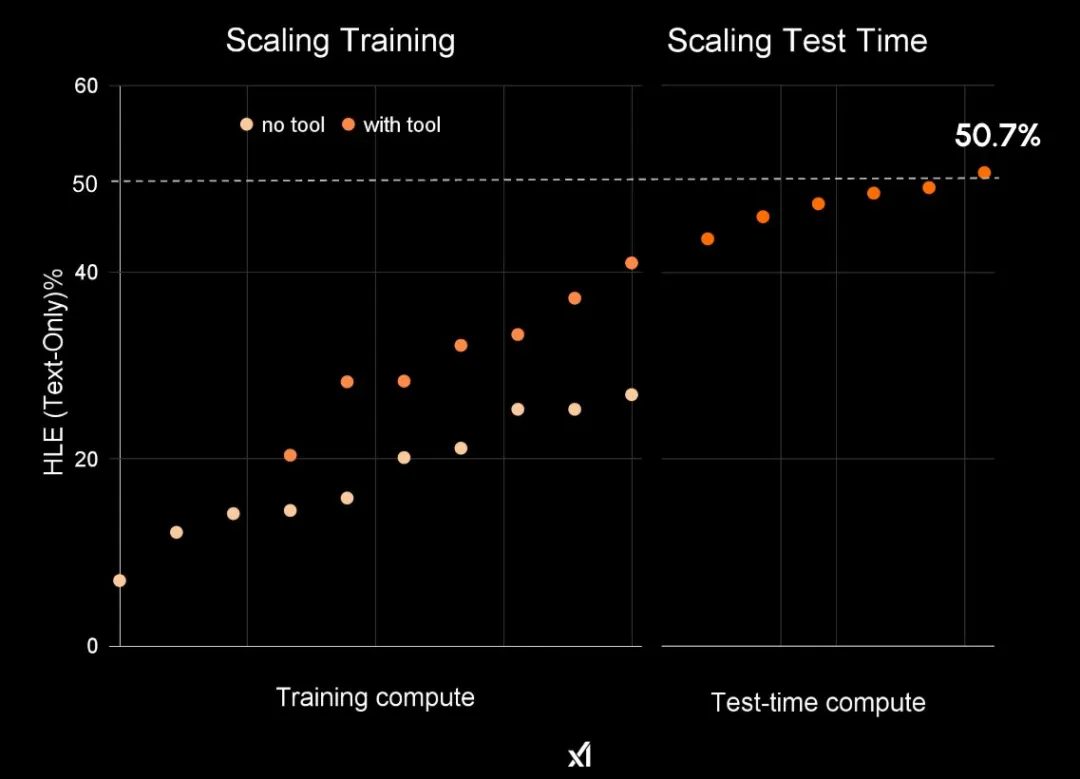
Grok 4站上大模型之巔,Scaling強化學習被視為頭號功臣。AI學者Karpathy卻潑出冷水:RL的本質局限或令它無法通往AGI。他提出另一種擴展範式——像人類一樣回顧反思,透過複盤學習取得突破。
RL的本質局限
強化學習的本質,是某次行動表現良好或糟糕,就微調未來類似行動的概率。Karpathy指出,RL只是把最終成敗的單一數值回傳,效率隨任務時長急劇下降,在長任務中局限明顯。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。