
 IXThinker·2025-07-19 14:40
騰訊混元新法提升模型情商 7B比肩GPT-4o
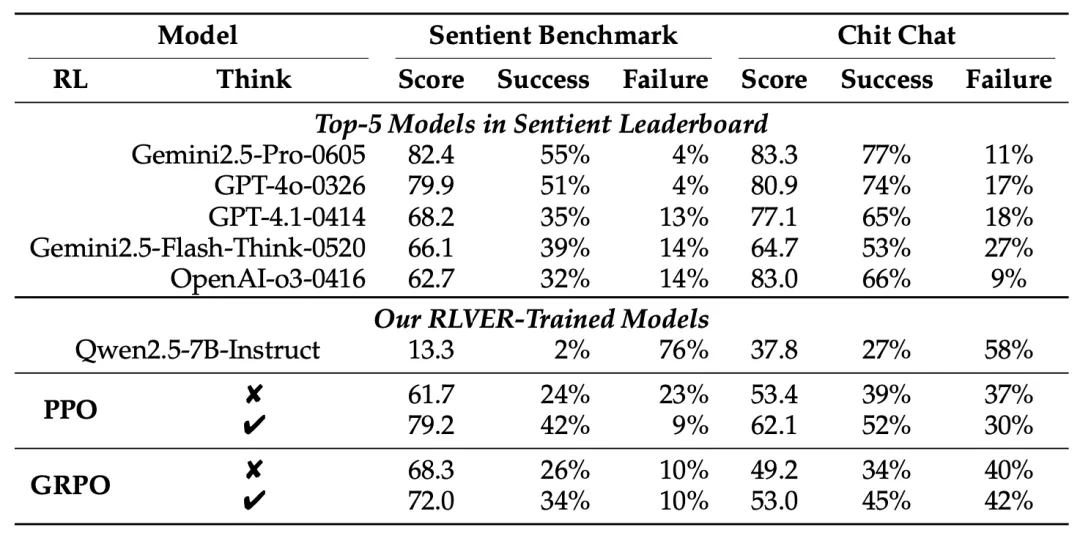
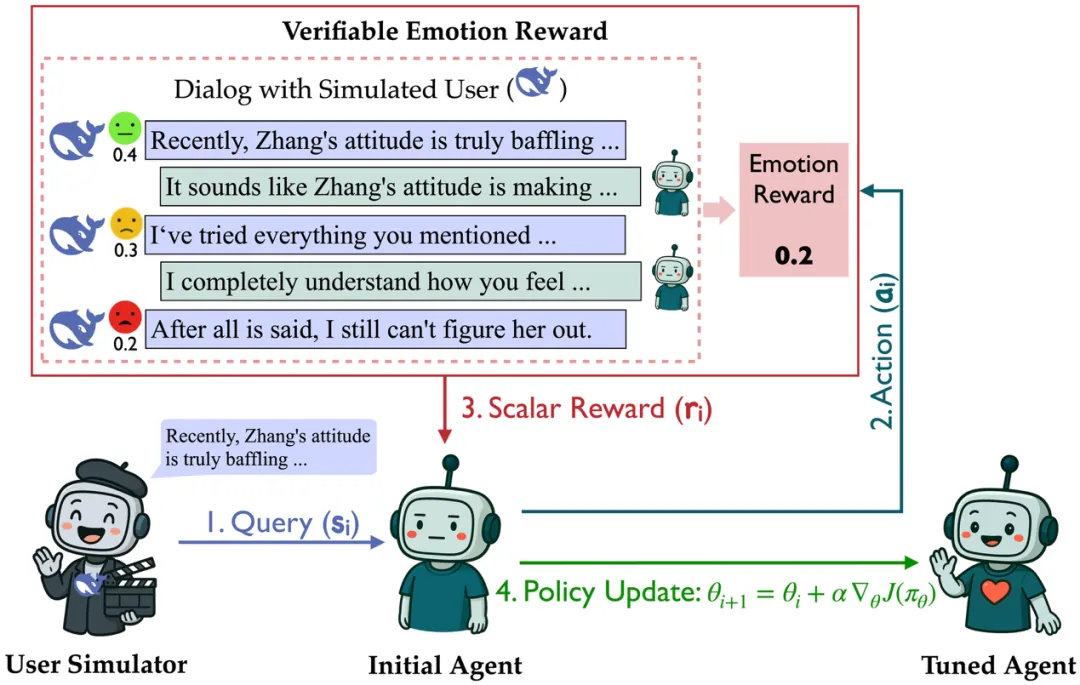
在沒有標準答案的開放式對話中,如何用強化學習提升大模型的「情商」是業界難題。騰訊混元AI數字人團隊系統探討這一領域的困境與解法,提出RLVER方法,令7B模型情商比肩GPT-4o,相關得分直翻五倍。
三大困境
開放式多輪對話高頻、多輪、強情境依賴,「好回復」因人而異。團隊歸納出強化學習在此的三大困境:真實多變的交互環境難以構建、主觀滿意度難以轉化為穩定獎勵、模型在真實交互中試錯成本高,訓練難以穩定高效。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。