
 IXThinker·2025-07-25 17:00
億級影片數據訓練 Being-H0提出VLA新範式
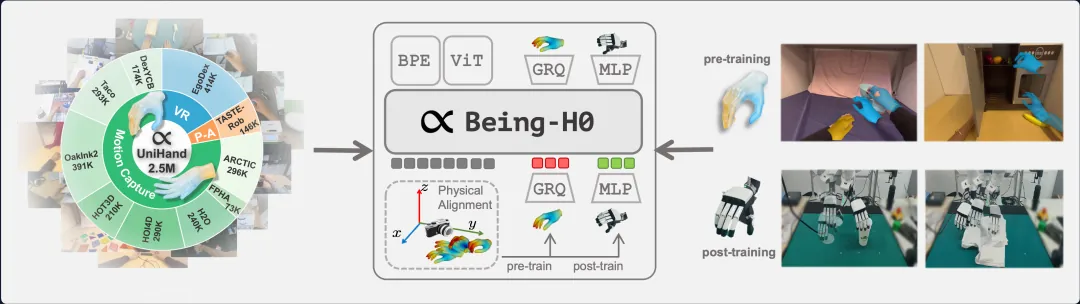
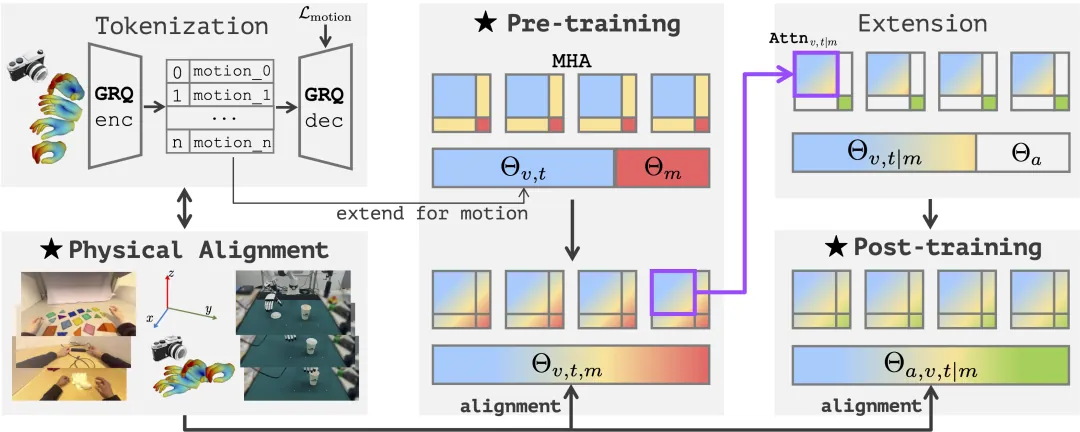
北京大學與BeingBeyond盧宗青團隊推出基於人類影片手部數據的大規模預訓練VLA模型Being-H0,嘗試突破具身智能的數據瓶頸。
真機數據的缺口
讓機械人從看懂世界到理解意圖、再到做出動作,是具身智能最受關注的技術重點,但真機數據的匱乏令VLA模型面臨瓶頸,現有數據規模較模型規模定律所需的上億級樣本少三個數量級。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。