
 IXThinker·2025-08-21 09:32
文本注釋助蛋白質語言模型釋放預測潛能
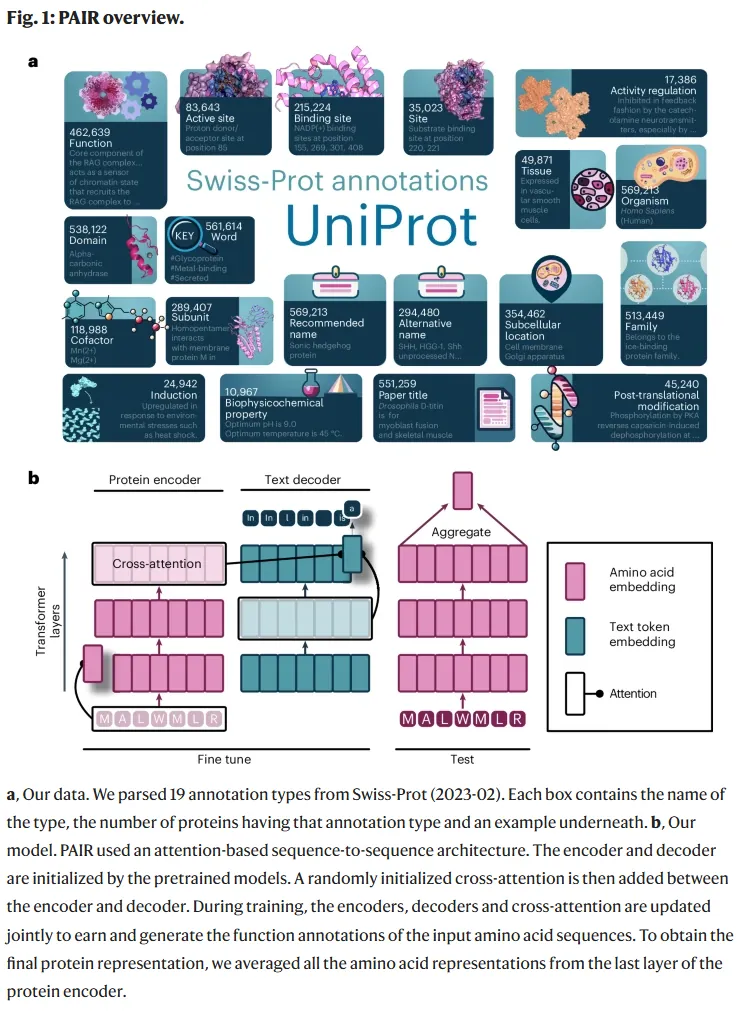
蛋白質語言模型憑氨基酸序列學習取得向量表徵,廣泛用於突變效應預測與蛋白質折疊等任務,但其成功依賴序列保守性與功能的關聯,而這種關聯常受進化與環境背景影響,研究人員於是轉向更直接的功能資訊。
為何要引入文本
序列保守性與蛋白質功能之間的關係並非恒常,進化和環境背景都會造成偏差,單靠序列學習有其極限。研究人員因此提出引入更直接的功能描述,讓模型獲得序列以外的補充訊號,提升功能預測的可靠度。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。