
 IXThinker·2025-09-16 12:00
王夢迪團隊發布TraceRL 統一擴散模型訓練
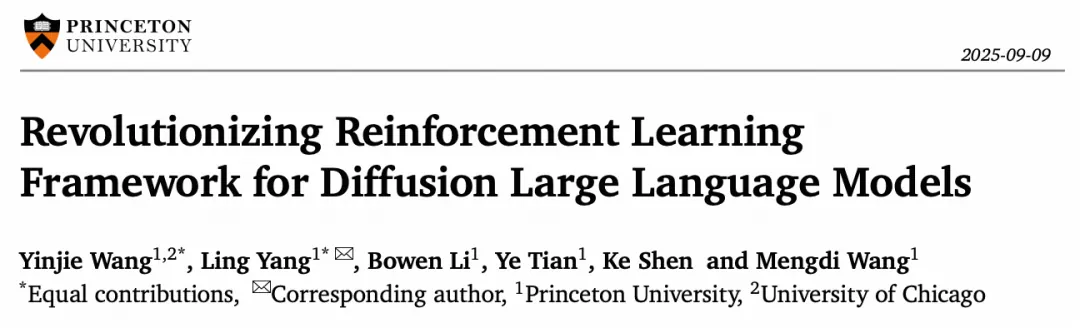
擴散語言模型正受矚目,卻缺乏統一有效的強化學習框架。普林斯頓大學王夢迪教授團隊提出軌跡感知強化學習框架TraceRL,適用於多種架構,令擴散模型的RL訓練邁向大一統。
為何需要統一
自回歸大語言模型在計算效率與吞吐量上有其局限,擴散語言模型(DLM)因而受到關注。但業界一直缺少可適用於全注意力、塊注意力等不同DLM架構的統一RL框架,研究各自為政。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。