
 IXThinker·2025-10-22 09:50
復旦Game-RL以遊戲數據強化視覺語言模型推理
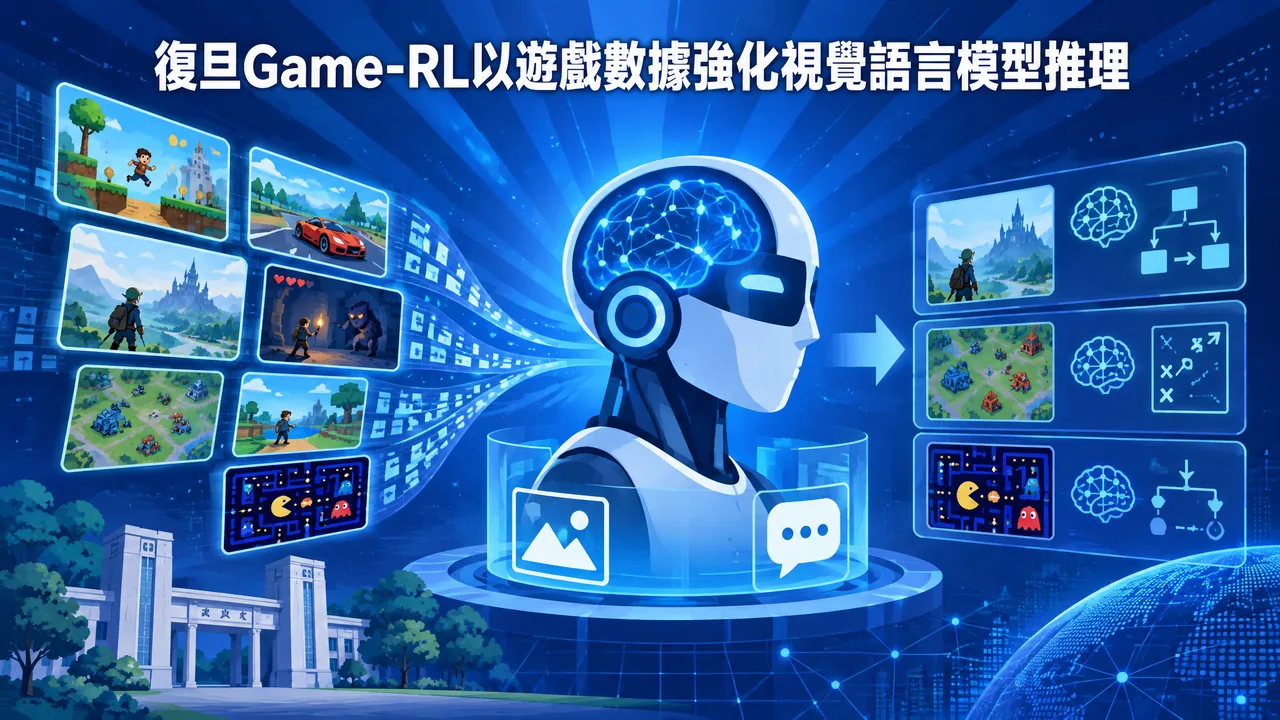
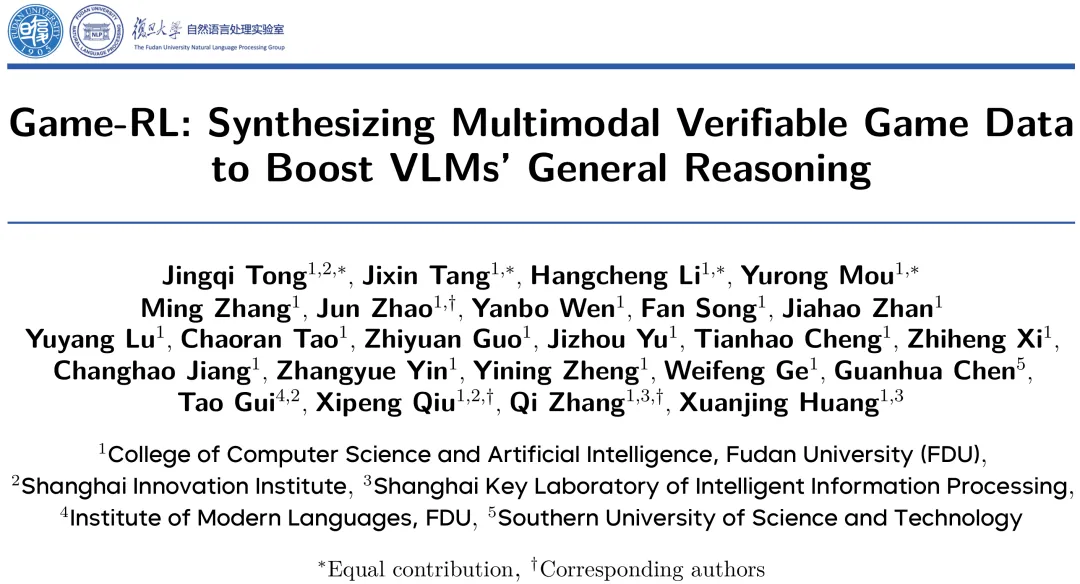
復旦大學NLP實驗室提出Game-RL框架,利用遊戲豐富的視覺與明確規則生成可驗證推理數據,並以Code2Logic構建GameQA數據集,提升視覺語言模型推理能力。
VLM訓練遇瓶頸
現有工作多利用強化學習提升視覺語言模型(VLM)的推理能力,但任務場景往往局限於幾何或圖表推理,領域單一制約了模型的探索空間與學習上限。
如何拓展VLM強化學習訓練的任務領域,成為擺在研究者面前的現實難題,其成敗也直接影響模型在真實複雜場景下的推理表現。業界正密切關注。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。