
 IXThinker·2025-10-22 22:20
GRACE框架讓模型先解釋再學Embedding
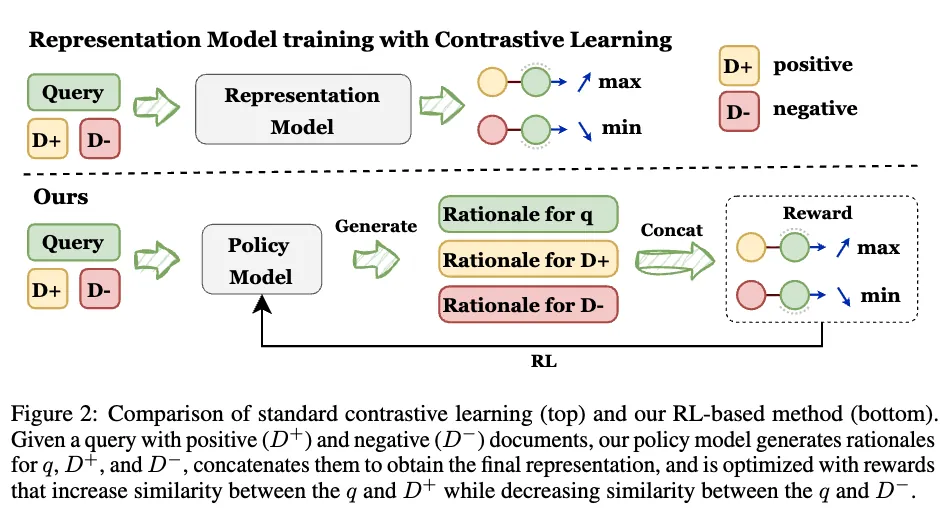
來自UIUC、ANU、港科大、UW、TAMU等多所高校的研究人員推出可解釋的生成式Embedding框架GRACE:讓模型先解釋文本語義,再學習向量表示,直擊過往方法把大模型當「啞巴編碼器」、無法說明相似緣由的共同缺陷。
黑箱之弊
從BERT到E5、GTE、LLM2Vec、Qwen-Embedding,文本表徵模型不斷演進,把文本映射到向量空間用於語義檢索、聚類與問答匹配。但「對比學習加池化」的通用做法無法解釋兩段文本為何相似。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。