
 IXThinker·2025-10-24 22:50
LatentExplainer拆解生成模型黑箱
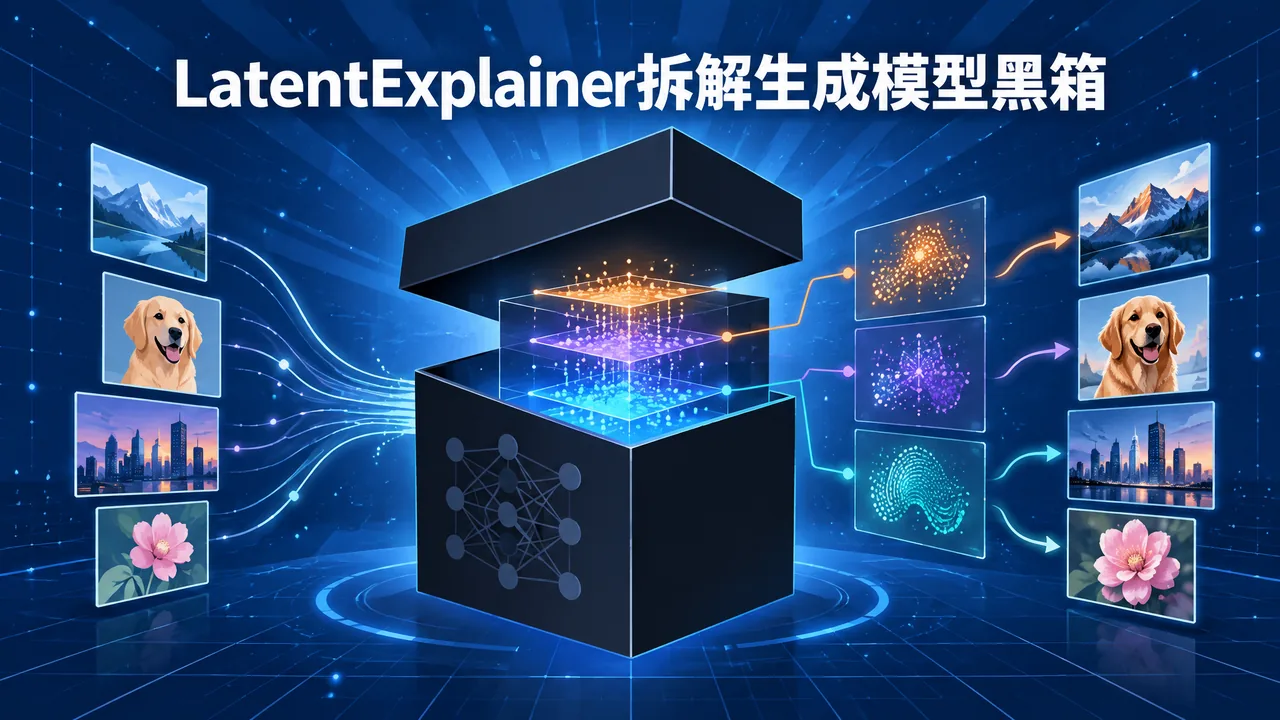
深度生成模型能創造以假亂真的內容,內部運作卻如巨大黑箱。埃默里大學團隊提出LatentExplainer框架並在CIKM 2025發表,自動把難解的潛在變量轉化為人類可讀的語義解釋,提升模型透明度。
黑箱困境
變分自編碼器(VAE)與擴散模型已成圖像、音訊乃至影片生成的核心技術,它們學習數據的潛在分佈,賦予AI強大的想象力與創造力。
然而模型內部如何運作、潛變量各自代表甚麼意義,外界長期難以捉摸,這直接制約了生成式AI在醫療等高可信場景的應用空間,也令除錯變得困難。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。