
 IXThinker·2025-10-24 17:40
ExGRPO讓大模型學懂分辨寶貴經驗
大模型以強化學習磨練推理能力時,並非所有經驗都同樣寶貴。上海人工智能實驗室聯同澳門大學、南京大學與香港中文大學提出ExGRPO框架,教模型識別、保存並善用高價值經驗,學得更穩更快。
研究動機
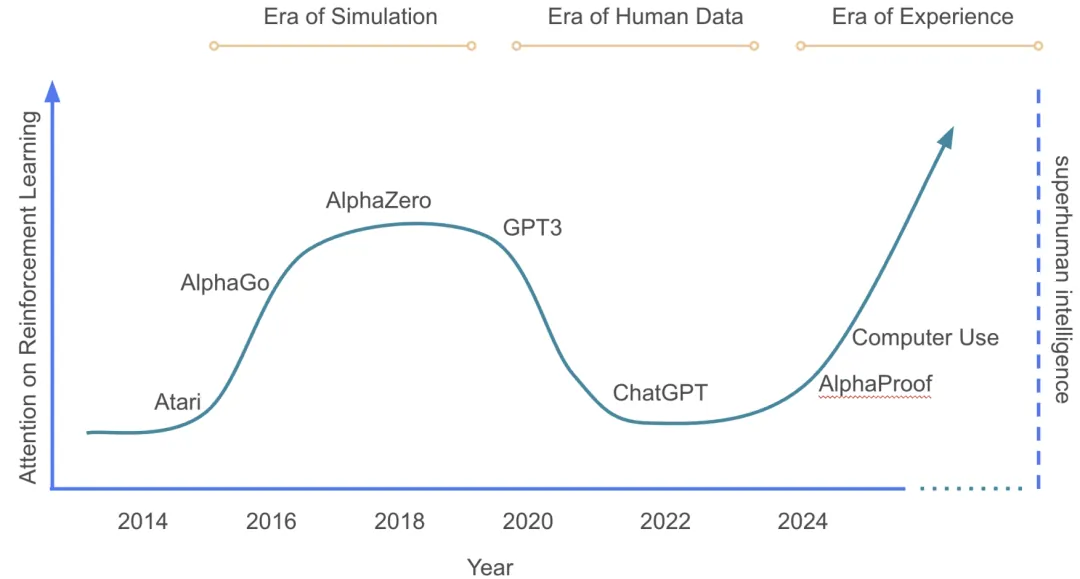
在基於可驗證獎勵的強化學習(RLVR)中,在線策略方法往往即用即棄,未曾認真分辨哪些經驗值得反覆學習,訓練效率有改善空間。
團隊由此提出一套經驗管理與學習框架ExGRPO,希望讓大模型在優化推理能力的道路上,走得更穩、更快,也更遠,減少盲目消耗算力。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。