
 IXThinker·2025-10-25 19:30
數據集蒸餾兩連發 小樣本近全量性能
數據集蒸餾(Dataset Distillation)以極少量合成樣本替代全量數據訓練模型,正成為大模型時代降本增效的務實路徑。兩篇頂會研究WMDD與GUARD,分別解決數據特性保留與抗擾動兩大難題。
蒸餾降本增效
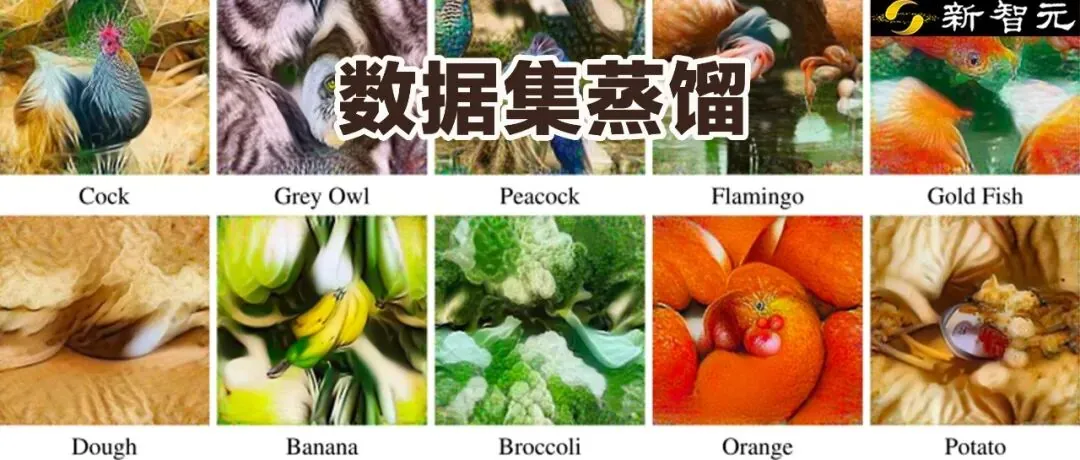
數據集蒸餾的目標,是用每類極少的合成樣本,訓練出接近使用全量數據的模型,從而大幅降低訓練時間、算力消耗與能源成本,在算力緊張的當下尤具現實意義。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。