
 IXThinker·2025-10-29 15:20
在線策略蒸餾結合RL與微調優勢訓練小模型
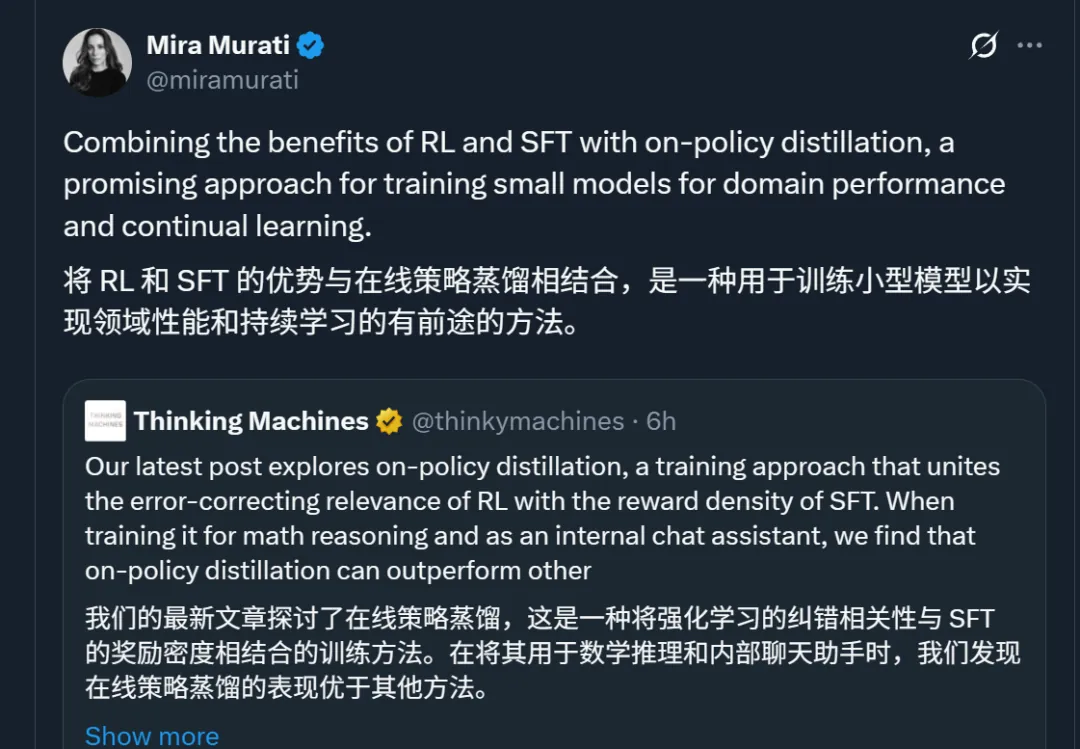
Thinking Machines提出名為在線策略蒸餾的大語言模型後訓練方法,結合強化學習與監督微調的優勢,讓小模型在專業領域獲得更強理解力。創辦人Mira Murati親自轉發介紹,引發廣泛討論。
方法原理
團隊以比喻解釋兩種主流訓練方式:強化學習如在線實戰,模型自行摸索、學得靈活但耗時耗力;監督微調如請家教,直接傳授正確答案但容易僵化。在線策略蒸餾則設法取兩者之長。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。