
 IXThinker·2025-11-07 12:40
新研究挑戰逐token生成 連續向量更省算力
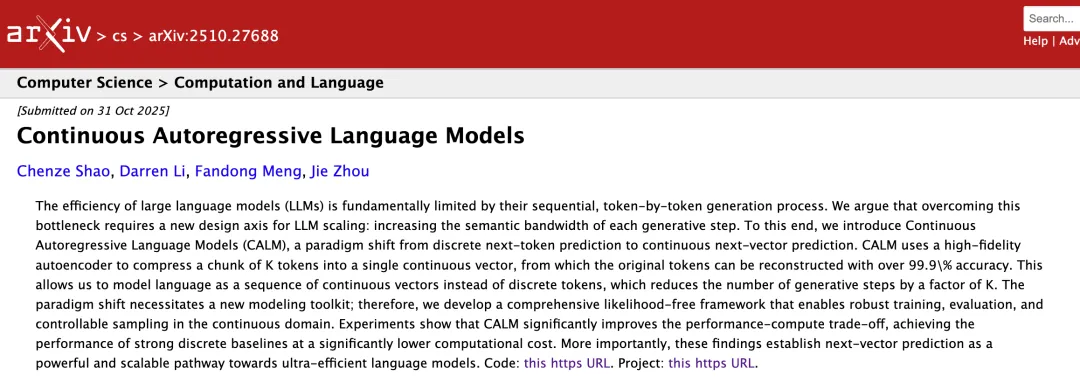
微信AI與清華大學合作提出CALM(連續自回歸語言模型),把逐token生成改為預測連續向量,K個詞元打包成一個向量後,生成步驟可減至原本的1/K,兼顧性能與算力成本。
範式反思
大模型一個token一個token地生成,效率始終有限。團隊的判斷是:單個token能裝載的資訊太少,不如把K個詞元壓縮為一個連續向量,讓模型從預測下一個token轉為預測下一個向量。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。