
 IXThinker·2025-11-18 13:30
強化學習微調只改動少數參數之謎
強化學習令大模型性能大增,改動的參數卻少得出奇,這個反差長期令人費解。離開Meta的研究者田淵棟帶領團隊剖析可驗證獎勵強化學習(RLVR)的訓練動態,給出系統解釋。
稀疏更新表象
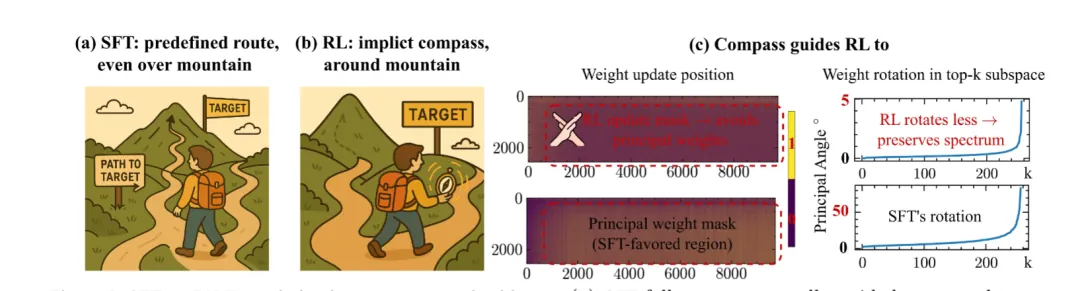
論文指出,參數更新的稀疏只是表面現象。對同一個預訓練模型而言,無論使用甚麼數據集和RL算法,RLVR都只盯着同一小部分參數修改,這種一致性指向背後存在固定規律。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。