
 IXThinker·2025-11-25 16:30
FP16破解強化學習訓推不一致難題
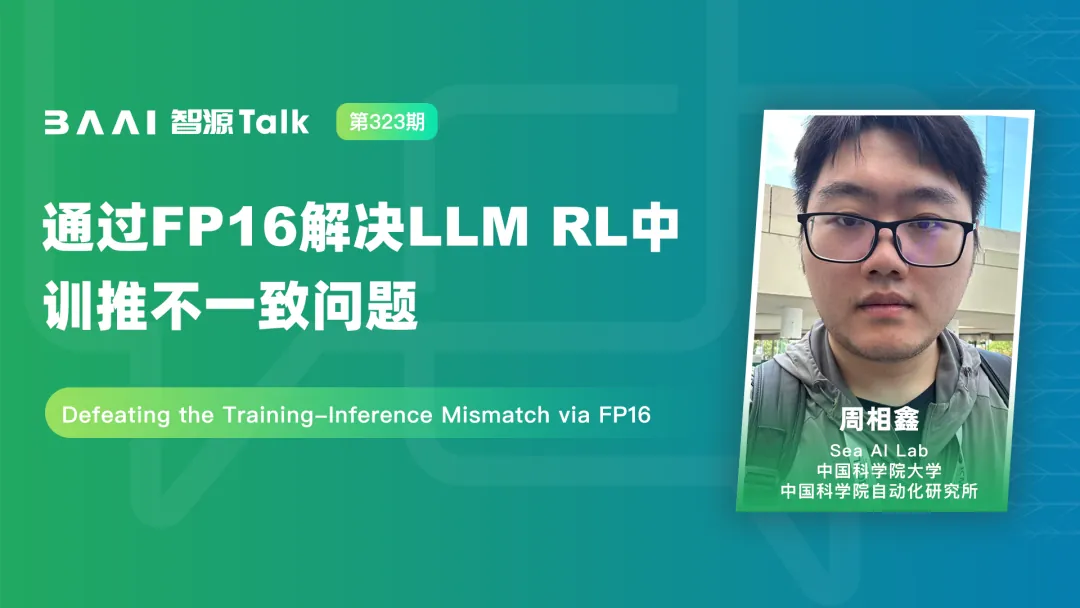
大語言模型強化學習微調為何常常不穩定?來自中科院自動化所的博士周相鑫在智源報告中給出答案:問題出在訓練與推理的數值精度不一致,而解法出奇簡單——改用FP16。
訓推不一致之謎
強化學習微調時,訓練與推理策略之間的數值不匹配常導致性能波動與訓練不穩定,是當前LLM強化學習的頭痛問題之一。報告從數值精度角度切入,系統剖析這一訓推不一致的成因。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。