
 IXThinker·2025-11-29 13:40
只用難樣本免SFT多模態後訓練新範式
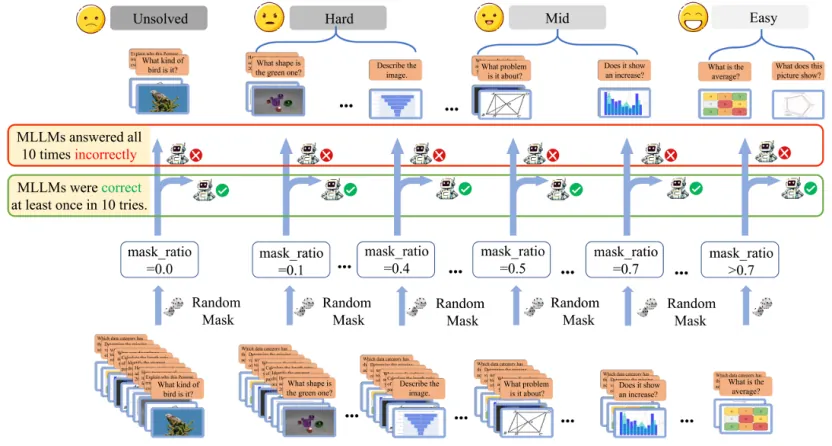
多模態大模型後訓練迎來新發現:只用中等與困難樣本、完全不做SFT的GRPO-only範式,反而在視覺推理與感知基準上拿下幾乎所有最優成績。這項獲AAAI 2026接收的研究,挑戰了「先SFT後RL」的慣例。
挑戰雙階段慣例
傳統多模態後訓練普遍遵循「SFT+RL」雙階段路線。由中南大學與中興通訊AIM團隊完成的新研究直接啃硬骨頭:完全跳過SFT,僅以GRPO在中等與困難樣本上訓練,成績反而全面領先。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。