
 IXThinker·2025-12-16 15:00
清華樂洋解讀RLVR 可驗證獎勵能否令LLM更聰明
清華大學樂洋將於12月16日直播分享NeurIPS 2025最佳論文榮譽獎工作,聚焦可驗證獎勵強化學習RLVR的系統性反思,探討其能否真正拓展大語言模型的推理能力邊界。
榮譽獎論文的直播
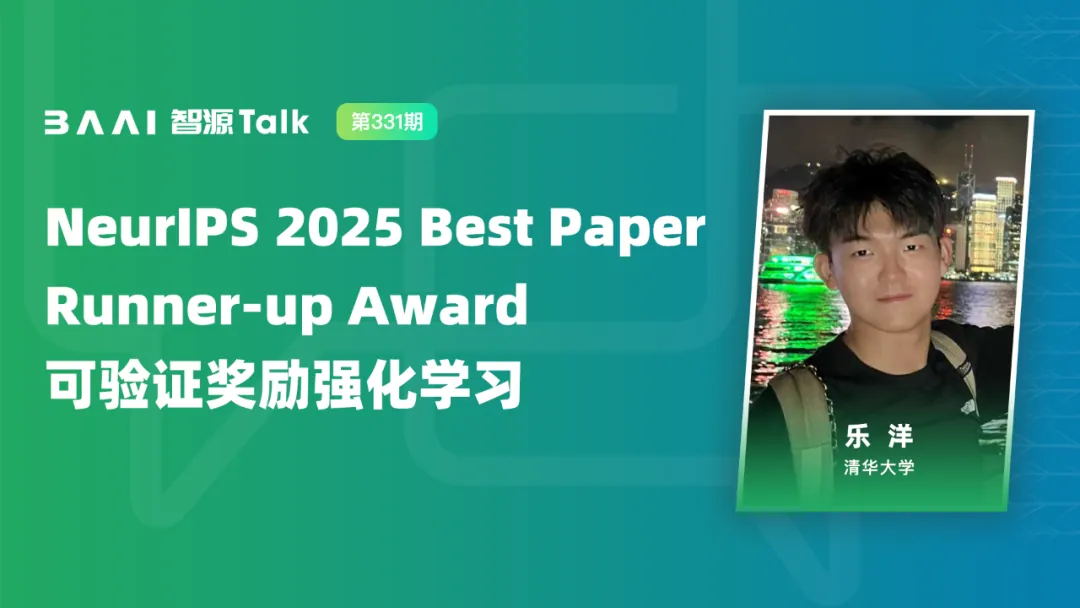
NeurIPS 2025最佳論文榮譽獎得主、清華大學的樂洋,將於12月16日周二上午10時30分進行線上報告,主題為可驗證獎勵強化學習:拓展大語言模型推理的新路徑。
這篇論文題為Limit-of-RLVR,探討強化學習是否真正激勵了大模型的推理能力。作為當下最受關注的訓練範式之一,對RLVR的反思極具話題性。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。