
 IXThinker·2025-12-18 18:30
ViLoMem讓大模型記住教訓 從錯誤中學習
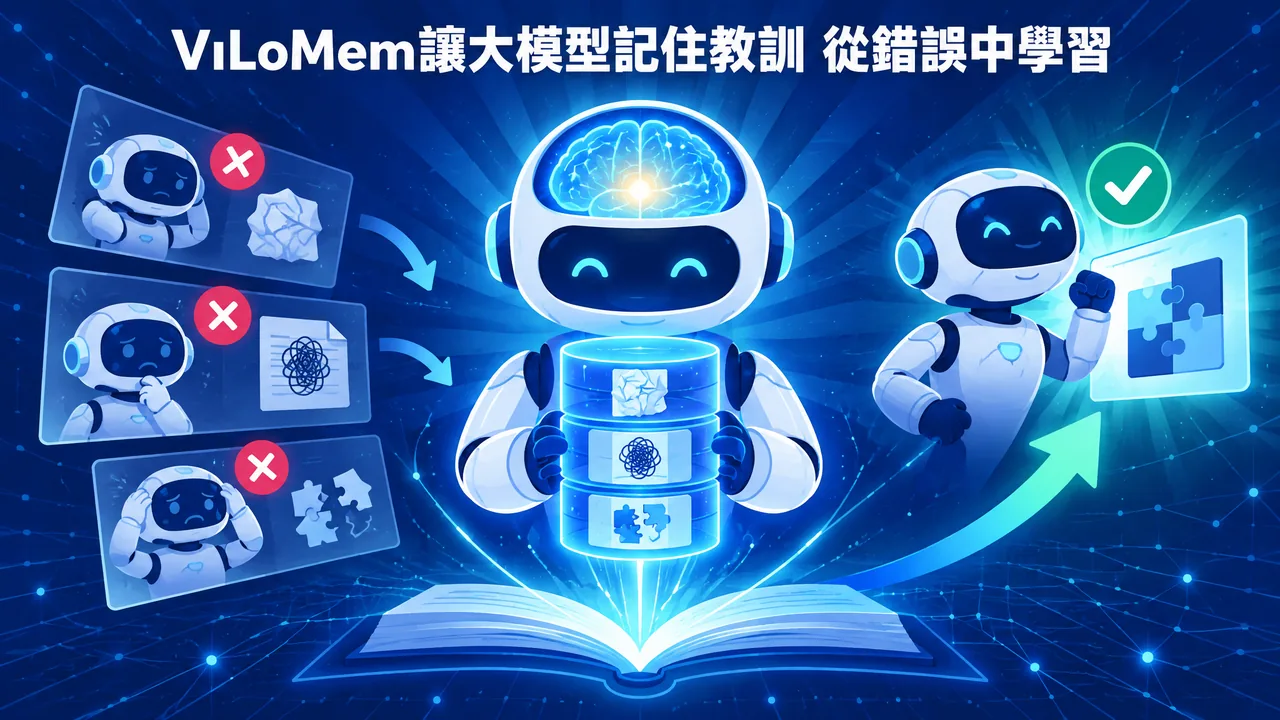
南京理工大學聯合百度等單位提出ViLoMem,以雙流語義記憶讓多模態大模型把視覺陷阱與推理錯誤分開存檔,毋須微調即可從錯誤中學習,多項基準成績明顯提升。
問題背景
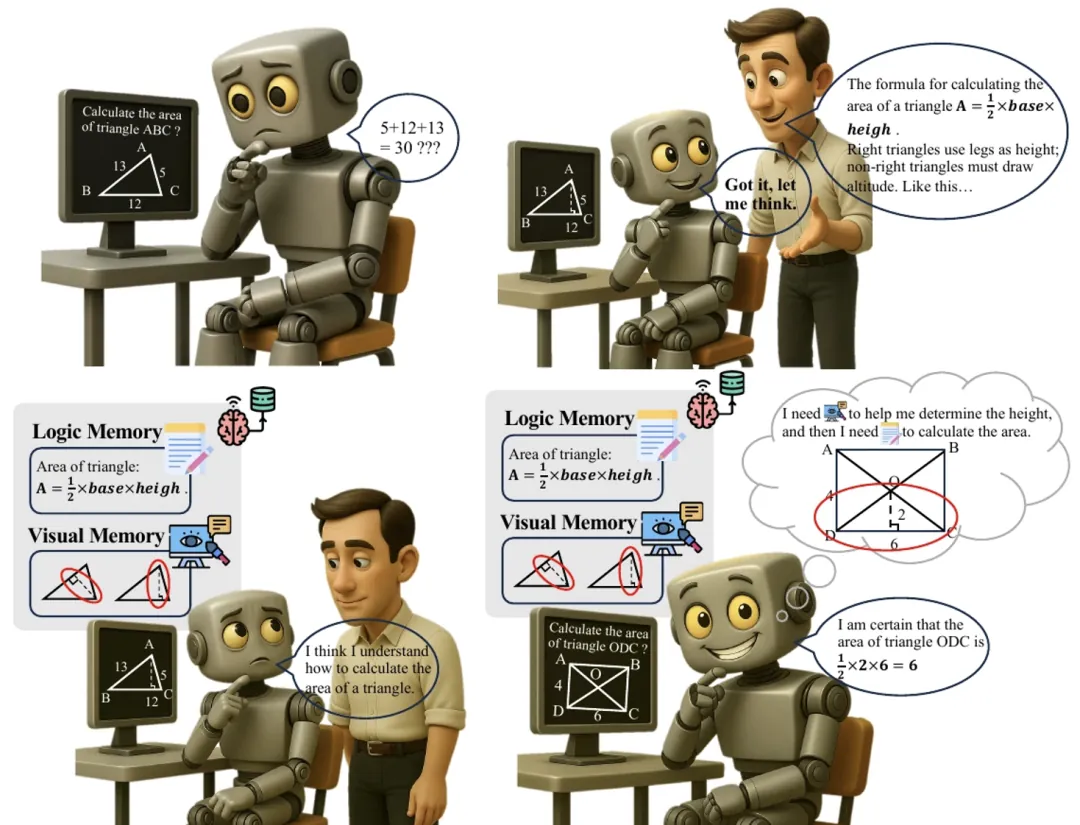
多模態推理模型常被詬病記不住教訓:同一類視覺陷阱或推理錯誤會反覆出現。ViLoMem的思路是讓模型像人一樣把錯誤經驗顯式存檔,遇到類似情況時調用,避免重複犯錯。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。