
 IXThinker·2025-12-18 14:40
北大HD²-SSC刷榜自動駕駛語義場景補全
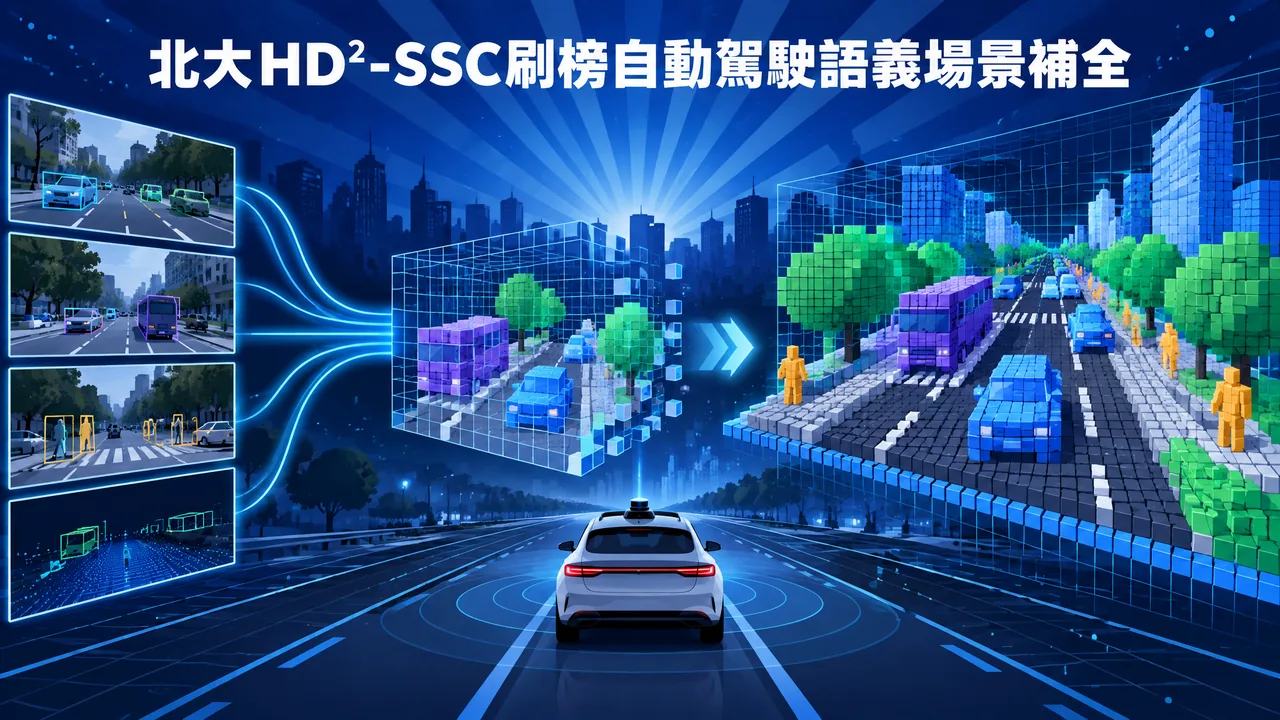
北京大學團隊提出視覺語義場景補全新方法HD²-SSC,從多視角圖像重建完整的三維語義場景,在SemanticKITT與SSCBench-KITTI-360兩個自動駕駛數據集上均取得當前最優表現。
任務定義
視覺語義場景補全旨在從多視角圖像重建完整的三維語義場景,預測空間中每個體素的幾何佔用狀態與語義類別,實現對複雜環境的精細感知與重建,廣泛用於自動駕駛等領域。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。