
 IXThinker·2026-01-13 14:20
WeDLM重構因果注意力 助擴散模型並行推理
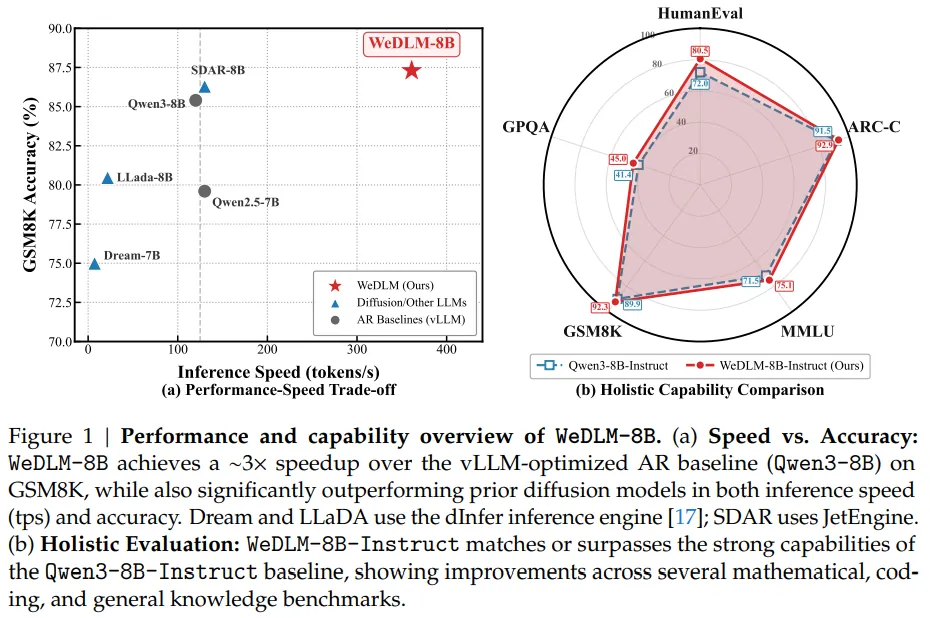
騰訊微信AI研究員劉瑷瑋將在智源TALK分享WeDLM,一種基於標準因果注意力重構的擴散解碼框架,目標是令擴散語言模型的並行生成兼容KV Cache,提升實際部署效率。
推理瓶頸
大語言模型的自回歸生成受逐詞解碼限制,推理效率面臨瓶頸。擴散語言模型雖支持並行生成,但依賴雙向注意力,破壞KV Cache的複用性,實際部署難以勝過優化的自回歸引擎。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。