
 IXThinker·2026-01-24 22:50
MedHELM框架評估AI真實臨床能力
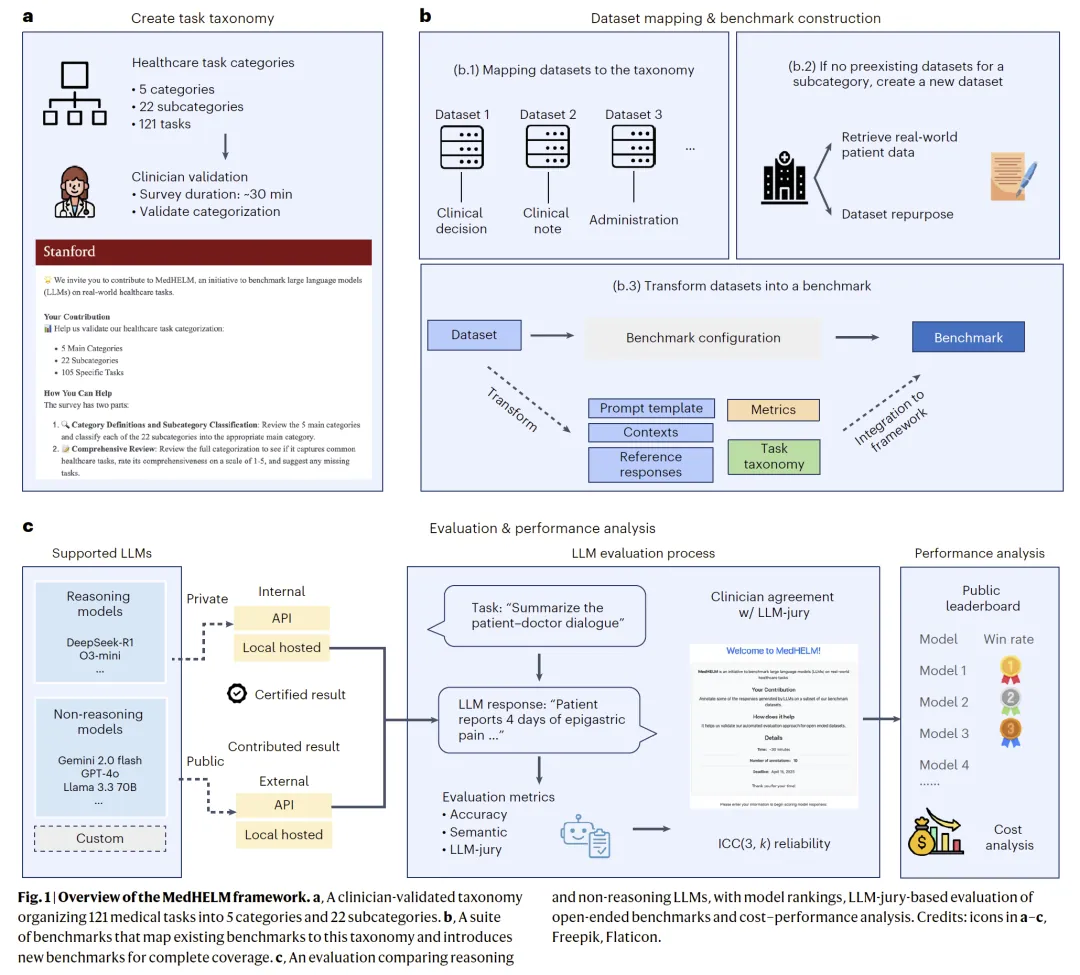
大語言模型在醫學考試近乎滿分,卻難反映真實臨床複雜度。研究人員提出MedHELM,首個面向真實醫學任務的綜合評估框架:五大類、22子類、121項任務的分類體系,37項基準,並系統比較9個前沿模型。
分類體系
MedHELM的核心是一套經臨床醫生驗證的醫學任務分類體系:劃分為五大類、22個子類與121項具體任務,顆粒度遠比標準化醫學考試貼近真實的臨床工作場景。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。