
 IXThinker·2026-01-24 19:40
超輕量獎勵模型SWIFT 推理快6.7倍
大語言模型的推理增強常用Best-of-N策略:同一輸入生成多條候選答案,再由獎勵模型評分篩選。但主流獎勵模型本身體量龐大、開銷高企,逐漸成為真實系統部署的核心瓶頸。
突破思路
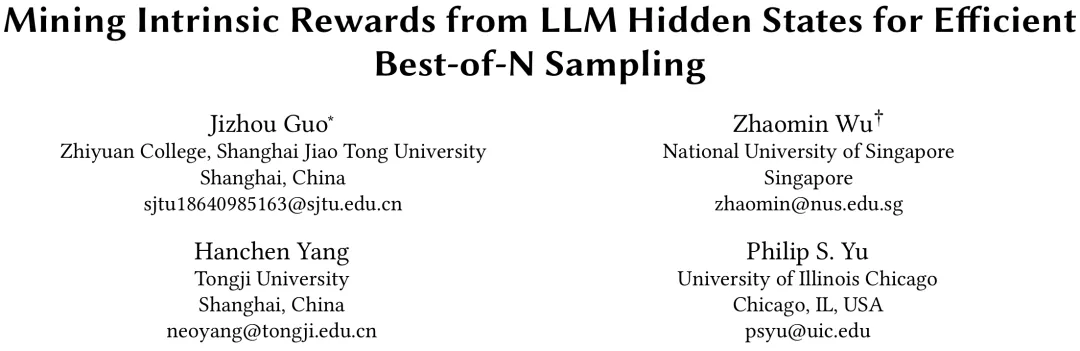
上海交通大學與新加坡等地機構合作提出新獎勵模型SWIFT,直接利用大模型生成過程中的隱藏狀態,無須另起爐灶的龐大網絡,參數量不足傳統模型的0.005%,極度輕量。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。