
 IXThinker·2026-01-30 08:30
MoE手機端部署新架構 內存峰值大減92%
混合專家(MoE)模型需把所有專家加載進內存,令手機等內存受限設備難以運行。一項ICLR 2026工作提出MoE-LRC架構,以動態局部駐留機制大幅降低內存峰值,兼顧性能與資源。
內存困境
混合專家模型通過稀疏激活專家,在保持計算效率的同時大幅擴展參數量,已成為大語言模型擴展的主流架構。但完整模型需將所有專家加載到內存,這在手機等內存受限設備上幾乎不可能實現。
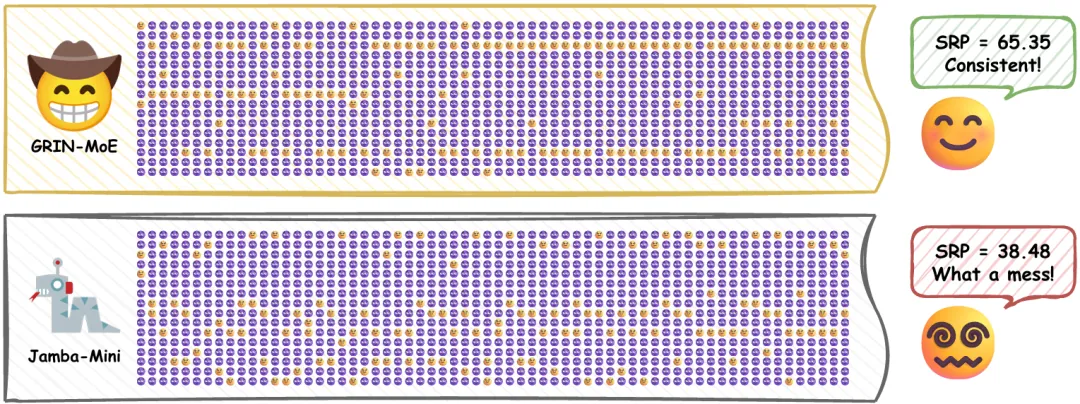
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。