
 IXThinker·2026-02-08 08:00
EID-Bench評交互問診 強推理未必是好醫生
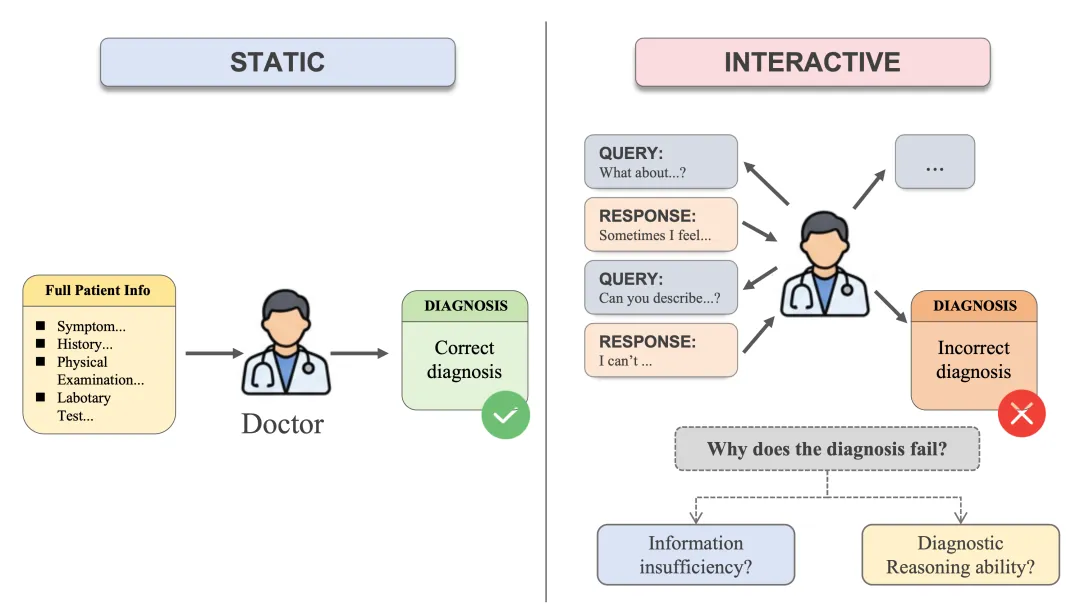
看醫生是一問一答、層層深入的過程,但大模型的醫療評測多停留在「資訊一次給足」的靜態問答。新研究提出EID-Benchmark,聚焦交互式問診中的證據搜集與評估,檢驗模型能否像醫生一樣診斷。
診斷本質是交互
現實中患者往往只能給出模糊零散的主訴,醫生需多輪追問與檢查選擇,逐步補全資訊、形成可驗證的證據鏈,並在資訊更新中校正假設。靜態問答範式無法覆蓋這一過程。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。