
 IXThinker·2026-02-11 15:20
牛津研究:AI醫療助手考試滿分實戰仍存風險
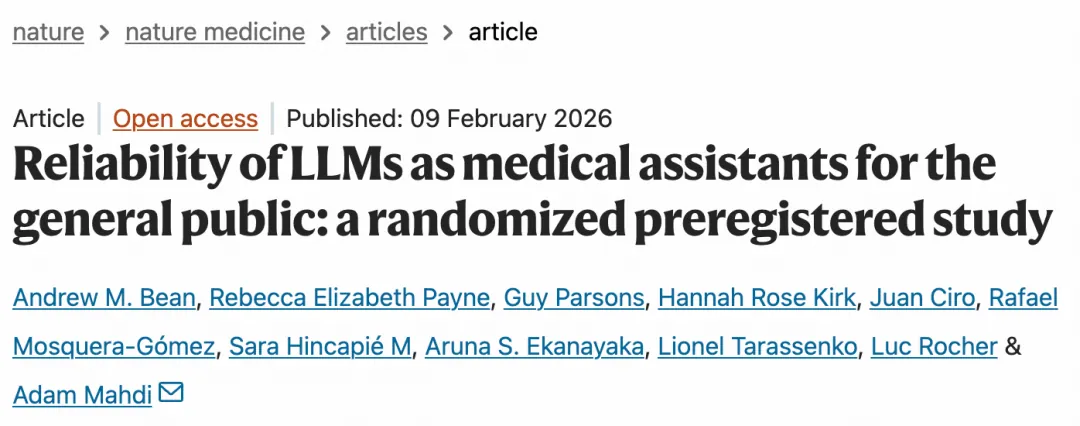
越來越多人身體不適時先問AI助手,大模型在醫學測評與醫師執照考試中的成績亦屢創新高。不過牛津大學研究團隊刊於《自然·醫學》的最新論文提醒,「考得好」與「用得好」之間存在明顯落差。
考試與實戰落差
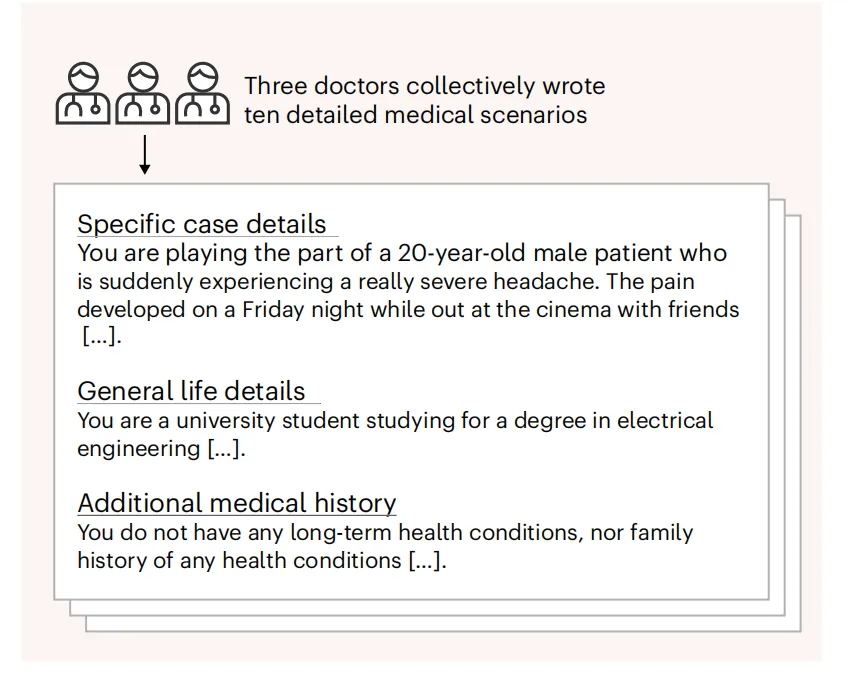
研究發現,儘管大語言模型在標準化醫學測試中表現優異,甚至能在專業醫師執照考試中達到或超越合格水平,但在真實公眾交互場景中,其輔助效果大幅衰減,未能轉化為可靠的健康建議。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。