
 IXThinker·2026-03-01 16:30
Meta新引擎讓多模態模型真正邊看邊聽
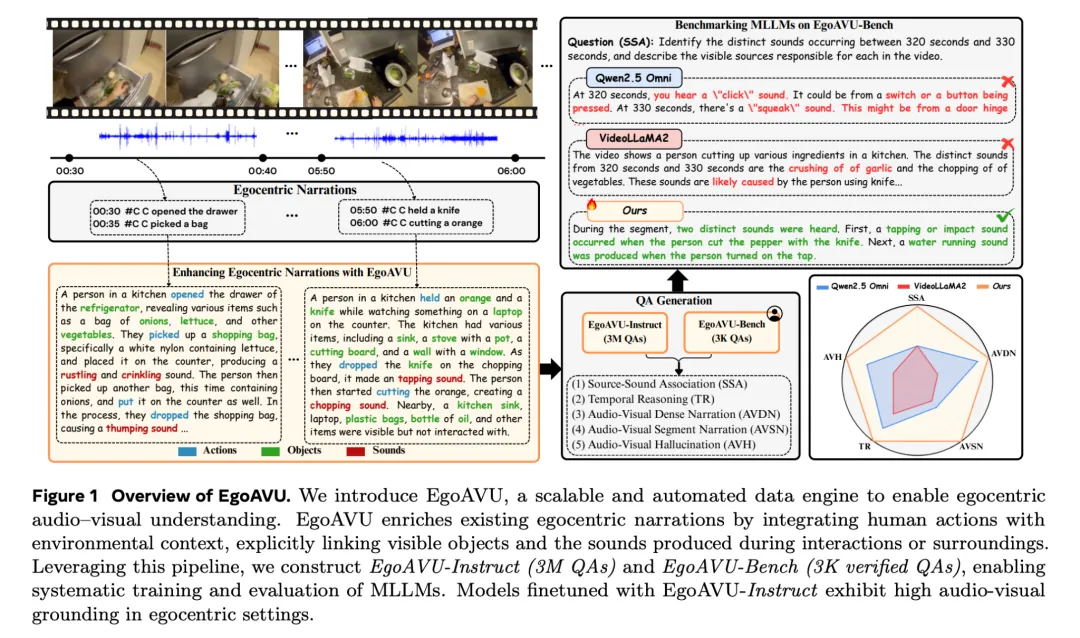
多模態大模型雖能同時接收聲音與畫面輸入,卻難以真正同步理解兩者。Meta聯合多所高校發布首個可規模化自動生成第一視角音影片理解數據的引擎EgoAVU,讓模型首次真正學會聽懂世界。
現狀的割裂
現時最強的多模態模型在第一視角任務中問題頻生:完全忽略音訊、錯判聲源位置,甚至以視覺線索推測聲音。這種只會看、不會聽的缺陷,被視為具身智能發展的一大瓶頸。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。