
 IXThinker·2026-04-14 23:20
大語言模型後訓練綜述 離策在策統一視角
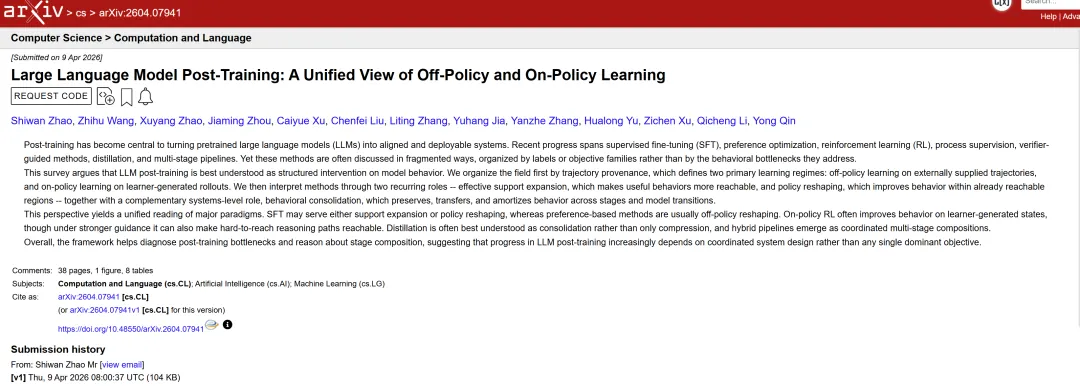
一篇arXiv綜述提出以統一視角理解大語言模型後訓練,按軌跡來源劃分離策學習與在策學習兩大範式,涵蓋監督微調、偏好優化與強化學習等方法,主張後訓練是對模型行為的結構化干預。
碎片化待整合
後訓練是將預訓練大語言模型轉化為對齊、勝任特定任務系統的核心階段。但相關方法長期以歷史標籤或目標函數分類討論,碎片化的視角令方法之間難以比較與組合。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。