
 IXThinker·2026-05-11 12:40
Next-ToBE新訓練目標破模型短視
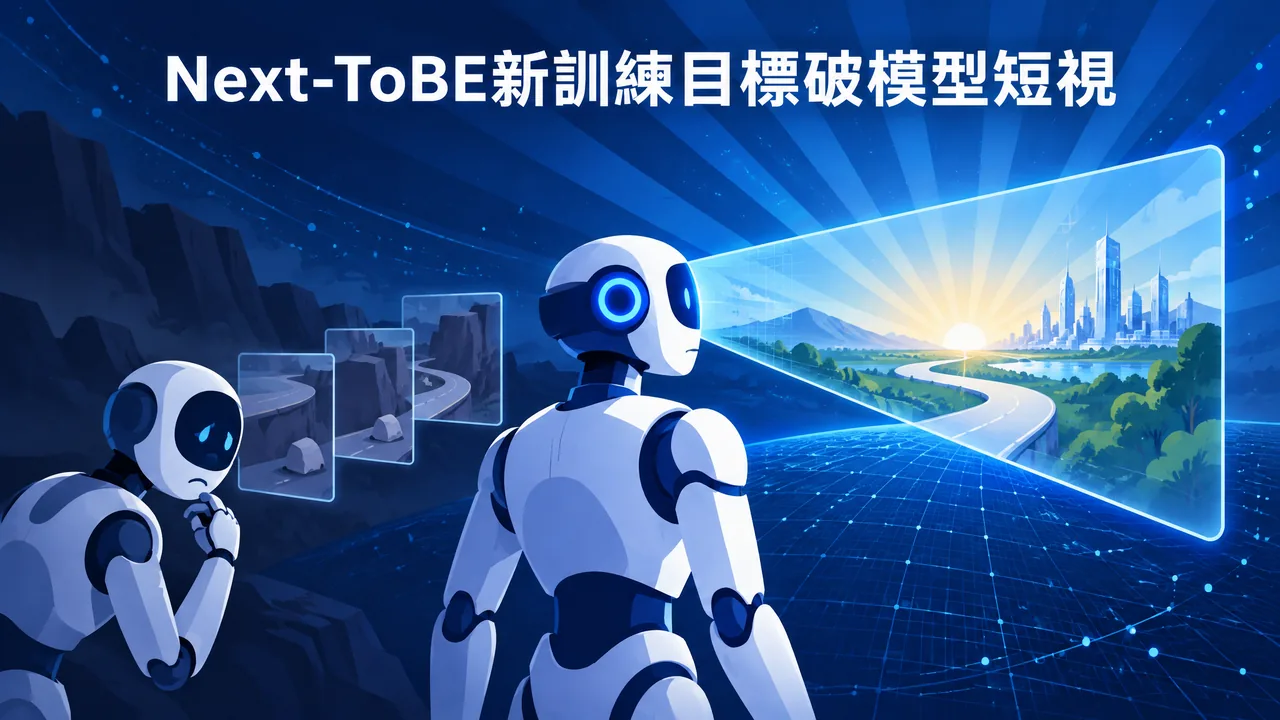
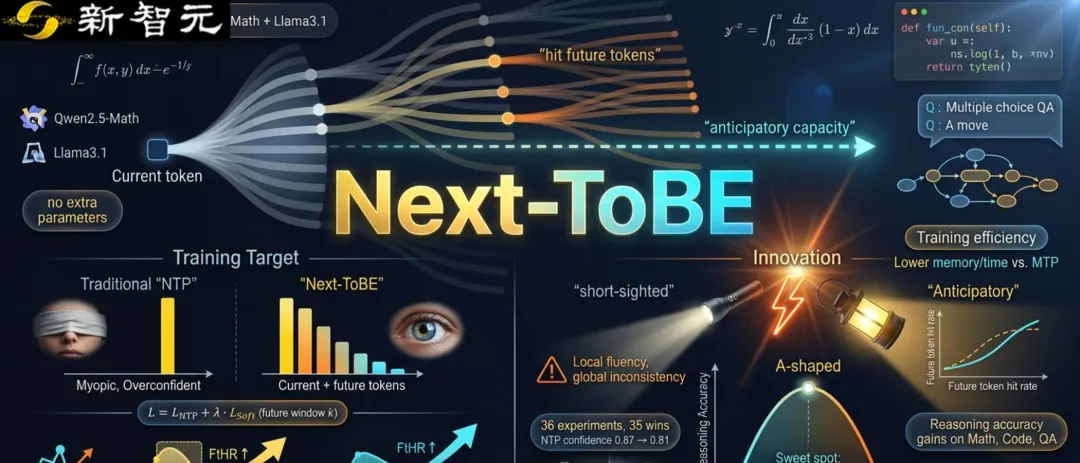
入選ICLR 2026的Next-ToBE方法直指大模型的「短視」問題:傳統下一詞元預測令模型每步只關注當前token。新目標讓模型在每步預測時兼顧未來token分佈,從而提升整體推理能力。
NTP的功與過
下一詞元預測與Transformer架構共同開啟大模型時代,令模型學會語言規律、吸收海量知識,提供了穩定可擴展的訓練範式;但其本質是逐步的局部建模,被形容為「盲人摸象」。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。