
 IXThinker·2026-05-15 20:40
復旦發布「世界動作模型」綜述 勾畫具身智能新前沿
復旦大學團隊聯合合作者發布世界動作模型綜述,梳理這一新興具身基座模型的定義、架構、數據、基準與挑戰。該方向統一環境建模與動作生成,被視為具身智能的下一個前沿。
從 VLA 到 WAM
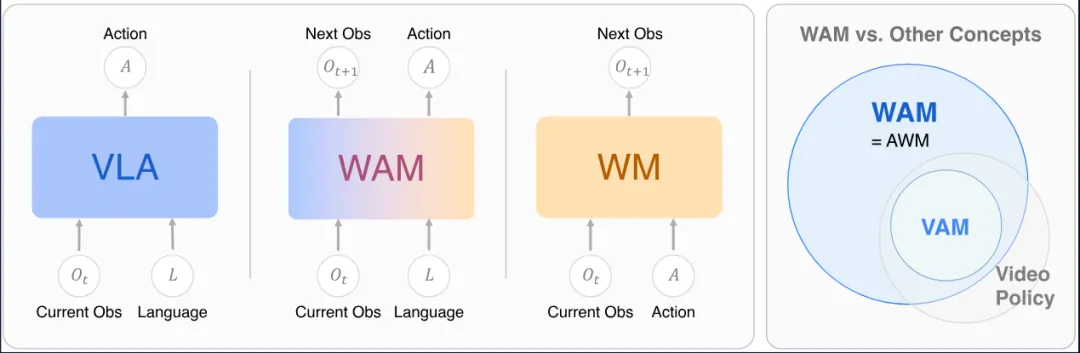
具身智能的目標,是構建能在非結構化物理環境中感知、推理與行動的機械人。當前主流的視覺語言動作(VLA)模型展現了通用策略學習的潛力,但本質上仍屬被動學習。
VLA 模型無法預測環境在干預之後的未來狀態,機械人只能照搬學到的策略,缺乏對物理後果的想像力。世界動作模型正是針對這一短板提出的統一框架。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。