
 IXThinker·2026-05-18 22:00
標量回饋對齊新方法 無需構造偏好對訓練
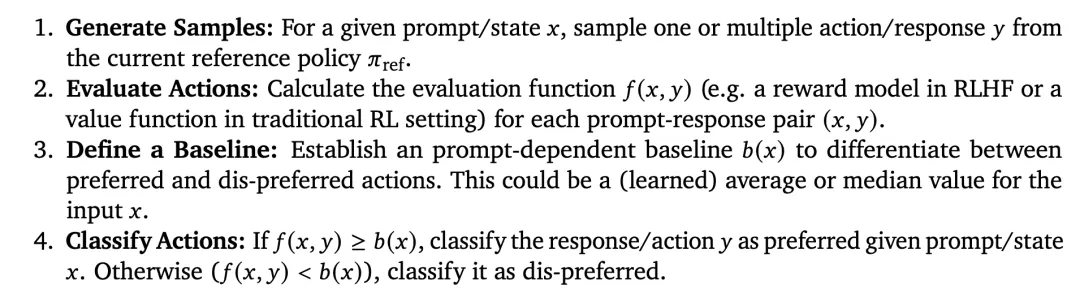
新加坡國立大學團隊提出閾值引導優化方法TGO,直接以單樣本標量評分對齊視覺生成模型:從分數分佈估計閾值,高於者視為準正樣本、低於者為準負樣本,無需成對偏好數據,更貼近真實標註場景。
偏好對之困
RLHF與DPO等主流對齊方法都要求反饋成對出現,但真實標註場景多為單個樣本的分數;構造成對數據成本高、利用率低,長期制約對齊訓練的實用性。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。