
 IXThinker·2026-06-04 15:10
大模型下一步是學會「睡覺」?谷歌康奈爾研究持續學習難題
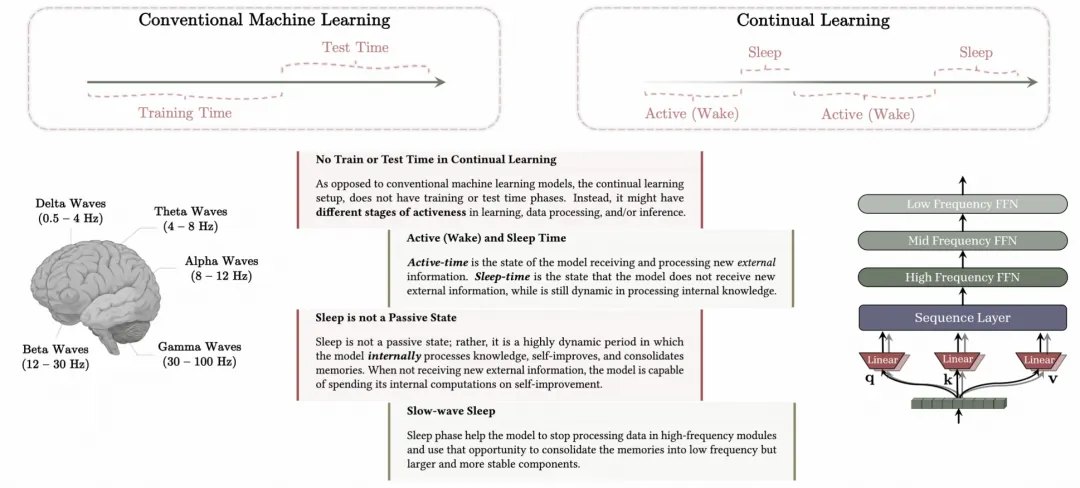
大語言模型部署後難以持續吸收新知識,微調又會引發災難性遺忘。谷歌與康奈爾的最新研究從人類睡眠獲得啟發,探討如何讓模型在保留舊知的前提下高效學習新信息,回應LLM實用化的核心難題。
模型部署後被凍結
大語言模型在完成部署後,通常進入近乎「凍結」的狀態,能夠執行預訓練階段已掌握的任務,卻很難像人類一樣持續吸收新知識,知識隨時間推移逐漸過時。
這帶來一個長期矛盾:停止學習,模型會落伍;持續微調參數,又容易引發「災難性遺忘」,新能力學進來的同時,原有能力被削弱甚至覆蓋。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。