
 IXThinker·2026-06-19 10:20
新基準評測大模型真實臨床文本理解能力
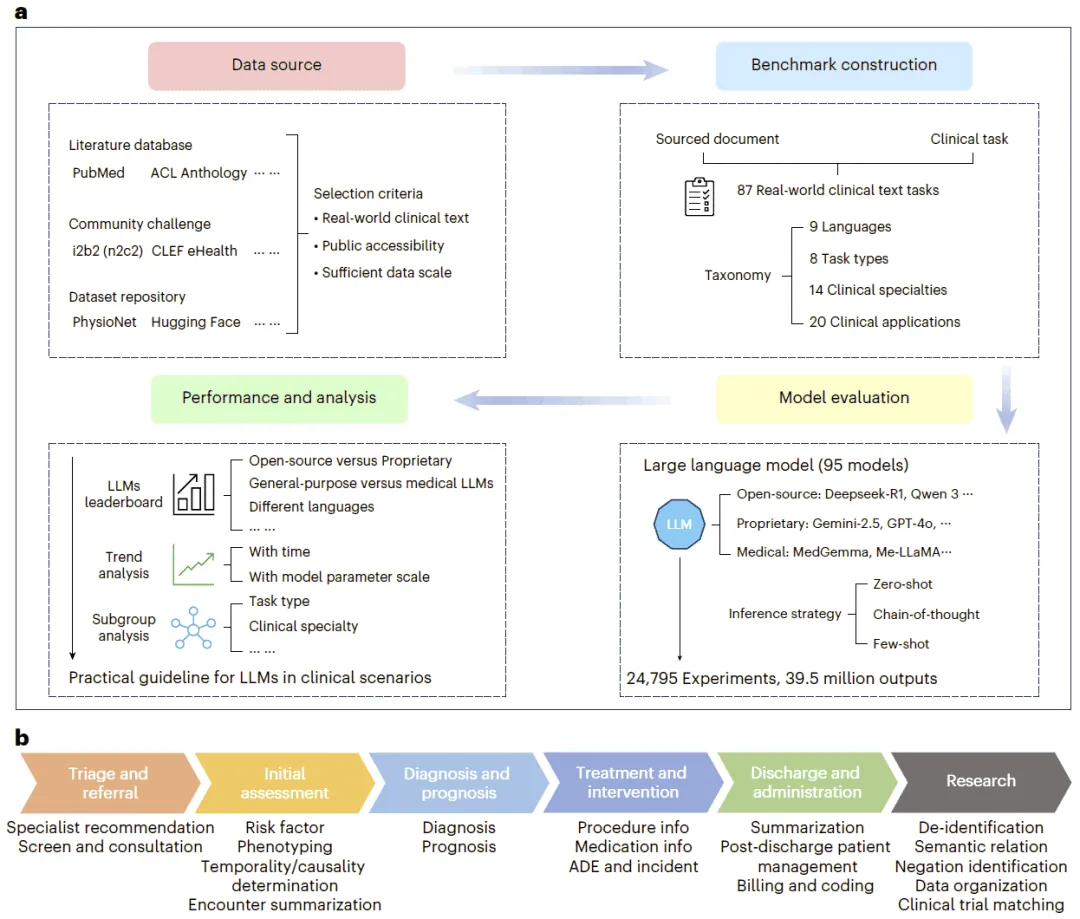
大語言模型在醫療領域潛力巨大,但現有評測體系多源於醫學考試或文獻,難以反映真實臨床語言現象。研究人員構建面向真實臨床文本的評測基準,更準確檢驗模型的實際能力,推動醫療人工智能落地。
現有評測局限
目前大多數醫學基準以考試題目或文獻文本為素材,與臨床環境中常見的縮寫、不規範表達、多源資訊混雜及跨學科推理存在明顯差距,導致模型在真實場景中的能力被普遍高估。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。