
 IXThinker·2026-06-21 15:01
研究揭示SFT的不完全學習缺陷
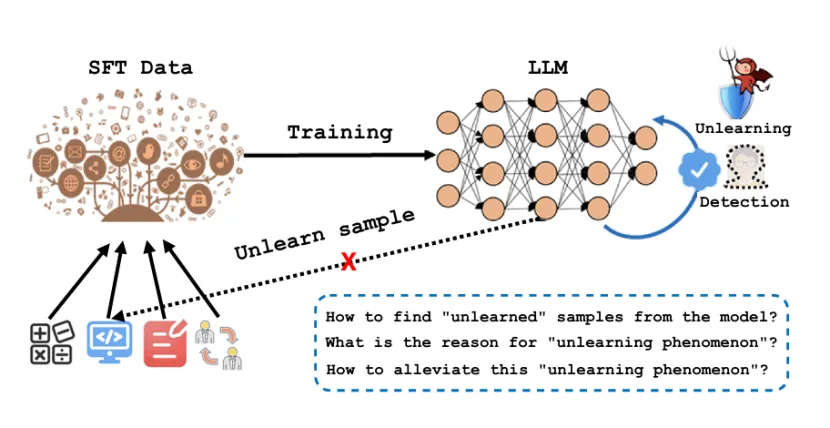
每個做過監督微調的工程師幾乎都遇過怪事:訓練損失收斂、基準分數上升,模型重答訓練集時卻總有一批樣本答不對。一項新研究首次系統揭示此現象,指出問題並非個例,亦非超參數或數據噪聲所致。
反直覺的現象
研究發現,即使損失函數已收斂、超參數已優化,模型在重複輸入訓練樣本時仍會穩定出錯,此現象並非數據噪聲或個別樣本問題,而是範式層面的系統性缺陷。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。