
 IXThinker·2026-07-05 12:40
七模態數據集揭VLM感知盲區 堆參數難救
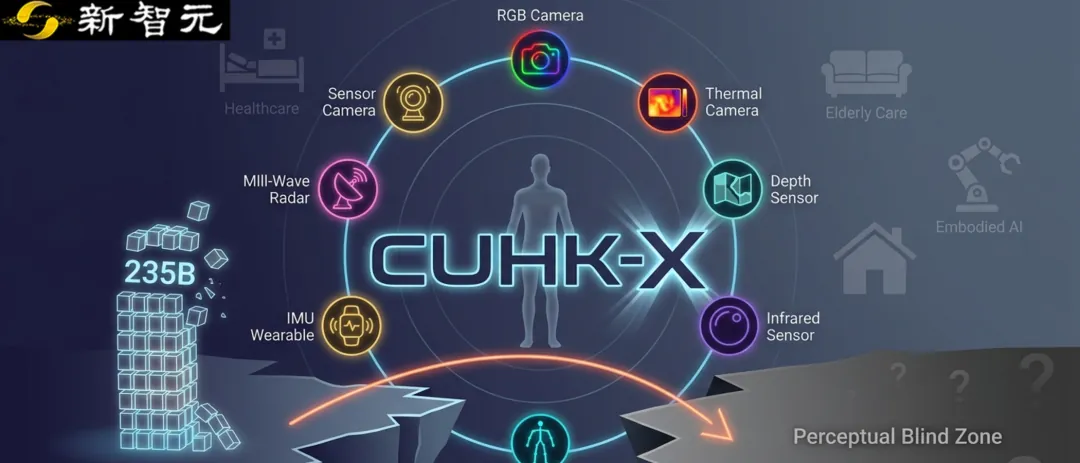
香港中文大學團隊聯同多所海外大學,構建首個七模態同步數據集CUHK-X,含逾六萬四千個樣本,涵蓋熱成像、深度圖、毫米波等非RGB信號,系統量化視覺語言模型在非RGB模態的能力斷崖,堆高參數亦難補救。
Demo裏的錯覺
過去兩年,視覺語言模型的進步幾乎都建立在RGB圖像上:給它一張照片,它能描述、能問答、能推理,看似無所不能。但離開RGB畫面,面對熱成像、深度、毫米波這些真實世界常見的信號,模型便集體「失明」。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。