
 IXThinker·2026-07-23 23:50
視頻世界模型推理提速2.59倍 無需重訓
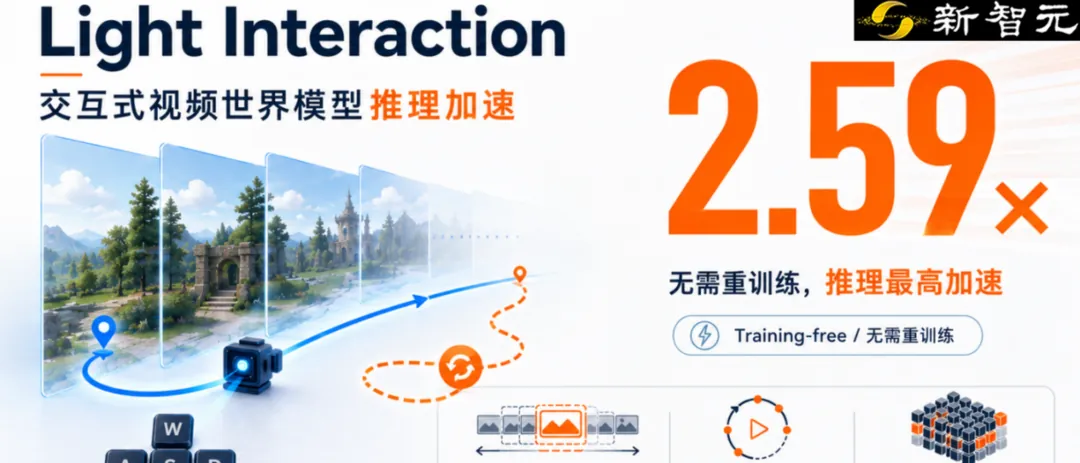
互動式視頻世界模型追求如遊戲般邊操作邊生成,但長軌跡交互令上下文、顯存與去噪成本急升。新研究提出純推理階段優化,不改參數亦毋須重訓,以相機軌跡作調度信號,配合三維稀疏注意力,推理最高提速2.59倍。
長交互的成本困局
視頻世界模型若要真正進入交互時代,須像遊戲引擎般依據前進、後退、轉向、回看等操作持續生成畫面,並在長時間探索中保持場景一致。然而生成鏈路越長,上下文膨脹、顯存壓力與多步去噪開銷越難壓制,成為實時交互的主要障礙。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。