
 IXThinker·2026-08-01 16:10
視覺預訓練效率反超文本 科學推理能力差三倍
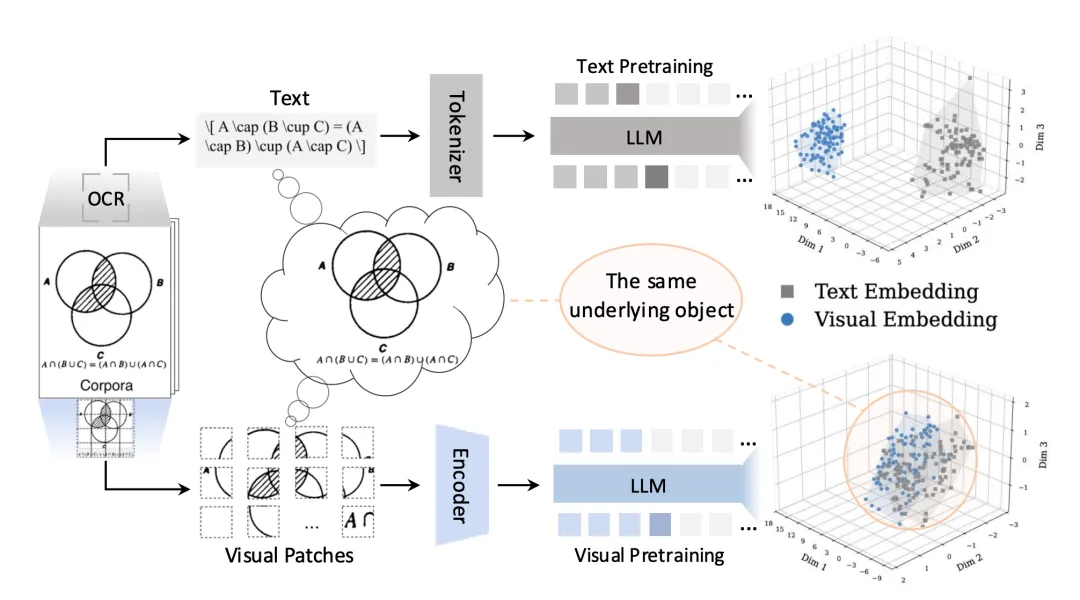
只讀文本的AI,科學推理能力只有「看圖」模型的三分之一。實驗顯示圖片承載文字無法無損翻譯的視覺邏輯,OCR降維令知識流失。團隊提出預訓練範式,讓模型直接在視覺表徵空間學習,成果落地多模態大模型。
反直覺的實驗結果
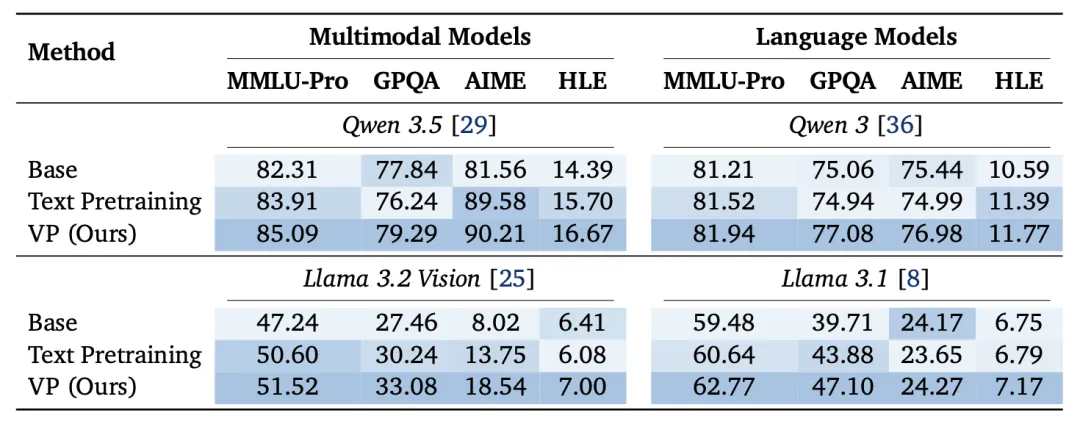
聯合團隊的實驗顯示,視覺預訓練只需約四分之一的文檔Token,便能取得遠超文本預訓練的增益;只讀文本的模型,科學推理能力僅為「看圖」模型的三分之一。結果證明真實語料中,圖片承載着文字無法無損翻譯的視覺邏輯。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。