
 IXThinker·2026-08-05 19:40
一句話同時編輯音視頻 模型理解聲畫同步
真實媒體是多模態的:口型對應語音、動作對應聲響。現有文本驅動視頻編輯能替換人物、增刪對象,卻難兼顧音軌。研究院與高校聯合團隊提出音視頻聯合編輯框架,一句話即可同步修改畫面與聲音,成果獲國際會議收錄。
問題背景
視覺與聲音並非兩條獨立信息流:人物口型對應語音,汽車運動對應引擎聲。完整的視頻編輯既要改動畫面目標,也要同步處理音軌中的聲學痕跡,並保留無關環境聲,只改畫面的結果往往顯得失真。
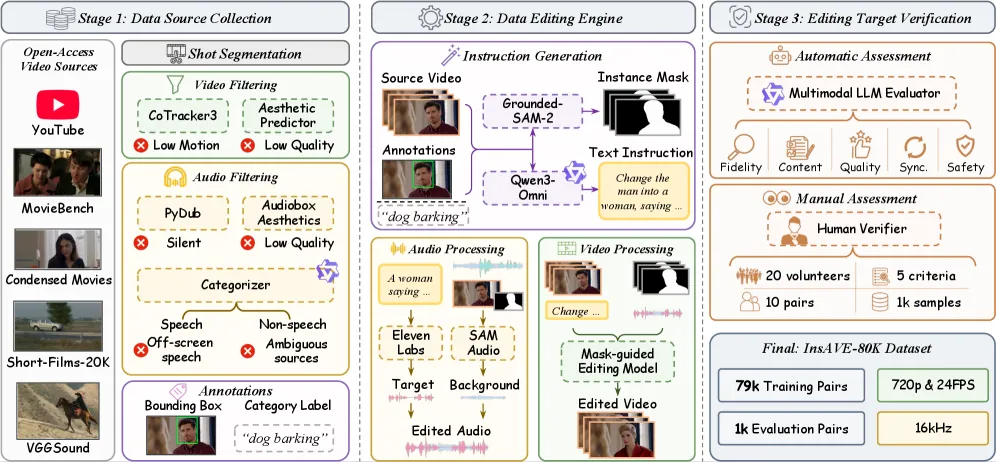
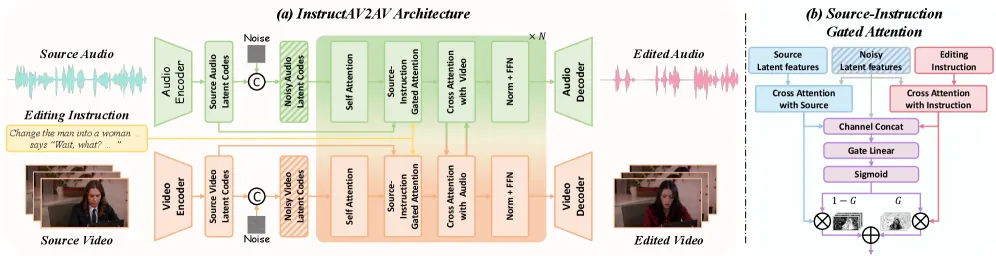
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。