
 IXThinker·2026-09-02 15:00
清華AIR團隊提出上下文因果學習框架
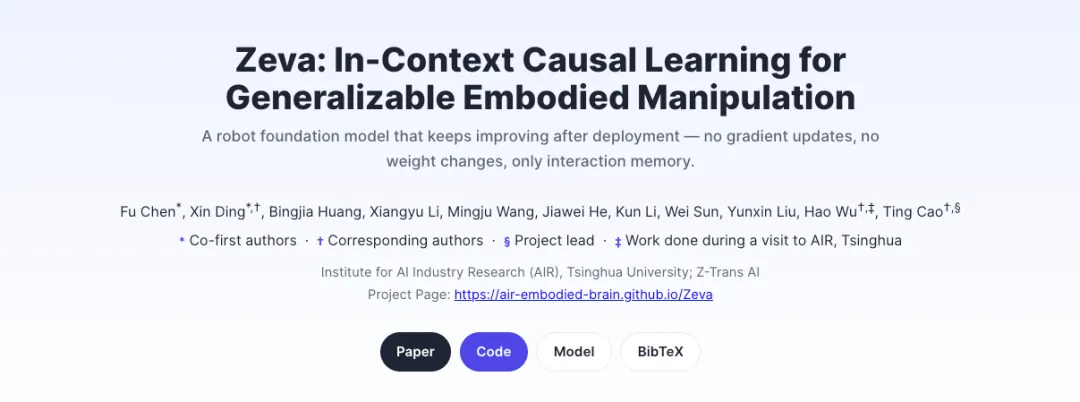
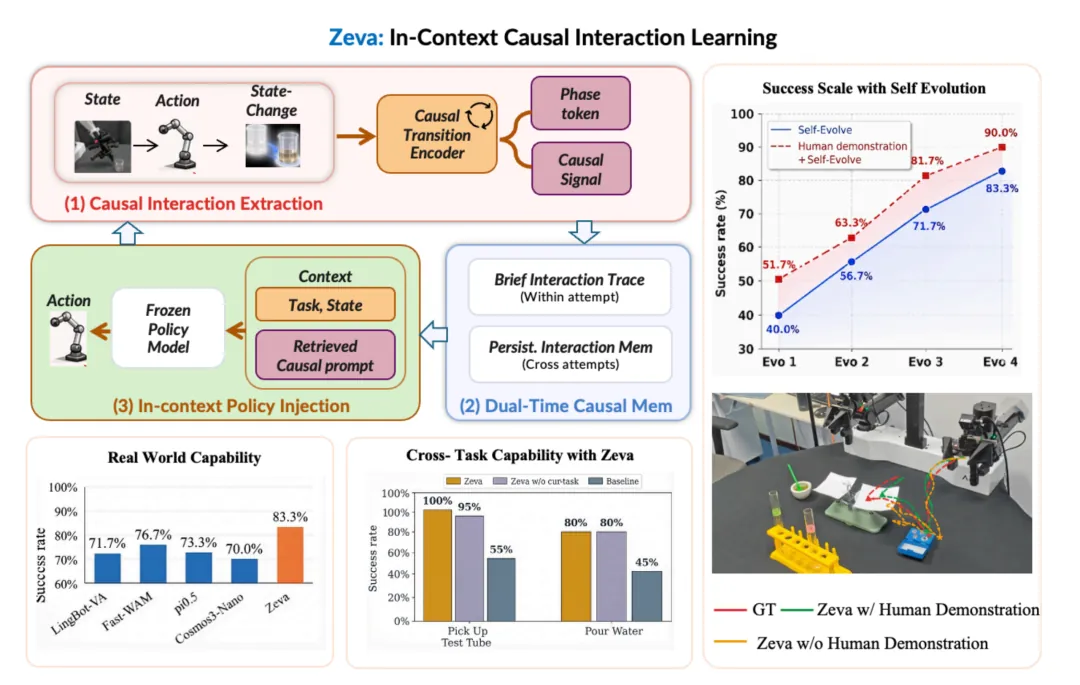
模型不更新權重,能力卻持續增長?清華AIR與域變換聯合發布的Zeva項目首度實現上下文因果學習,在多項具身任務上大幅提升凍結模型的成功率,挑戰模型必須持續訓練才能進步的慣常認知。
凍結模型持續進化
Zeva是首個實現上下文因果學習的具身世界模型,讓模型在不更新權重的前提下,從自身的交互經驗中持續累積能力,突破了傳統上模型需反覆訓練才能提升表現的框架。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。