
 IXThinker·2026-09-09 14:00
研究鎖定多模態檢索頭 揭長文檔盲區
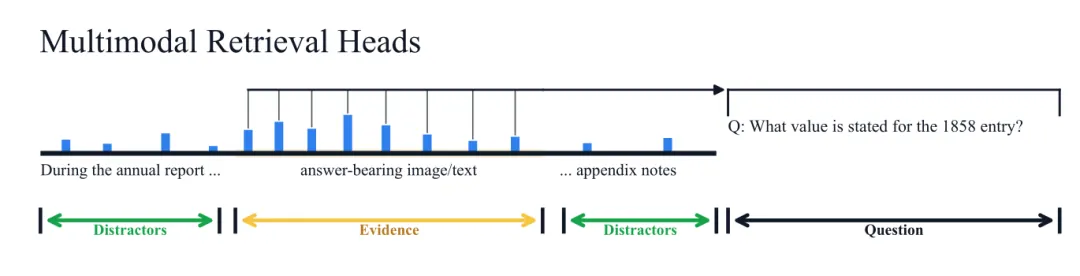
獲頂級會議接收的論文研究大模型處理長篇圖文文檔時的內部檢索機制,發現能處理文本的檢索頭難以定位圖像與表格等視覺證據。團隊構建多模態證據定位基準,證明對齊訓練可顯著提升檢索精度。
由裝得下到找得到
文檔智能體興起,模型開始直接處理財報、合同、研究報告等上百頁材料。能接收整份文檔,不等於能正確使用其中信息,首要是找到相關證據所在。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。