
 IXThinker·2026-09-21 16:00
清華提出視覺源幻覺新解釋極少數據達SOTA
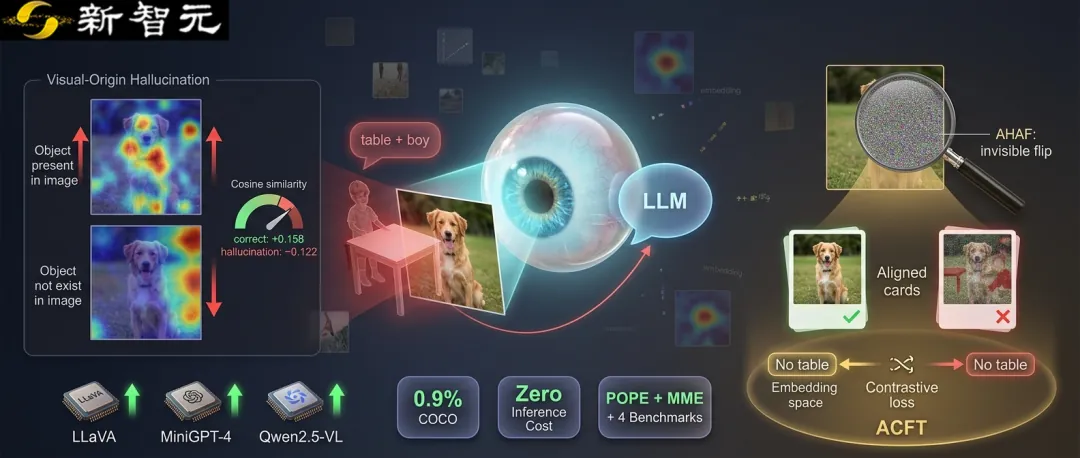
清華大學團隊研究多模態大模型的物體幻覺問題,指出根源不止語言先驗,模型在視覺與語言對齊過程中易受問題語義引導,生成與圖像不符的合理化回答;相關方法僅用0.9%數據即達領先水平。
幻覺場景重現
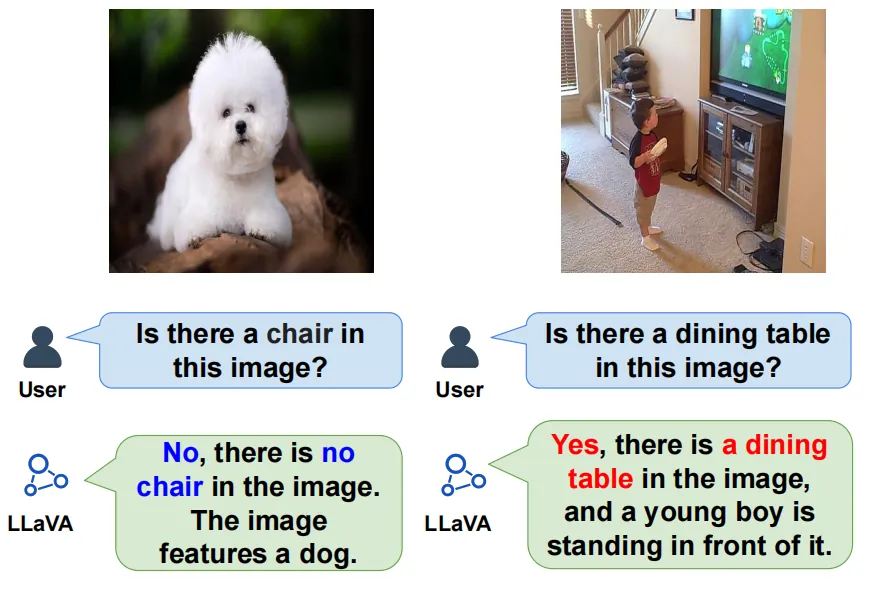
一張只有小狗的照片,模型正確回答圖中沒有椅子;另一張照片明明沒有餐桌,模型卻言之鑿鑿稱有一張餐桌,還有一個男孩站在前面。這種「看見」不存在之物、或對存在之物視而不見的現象,正是困擾多模態大模型的物體幻覺。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。