
 IXThinker·2026-09-30 17:00
極端稀疏監督刷新大模型後訓練認知
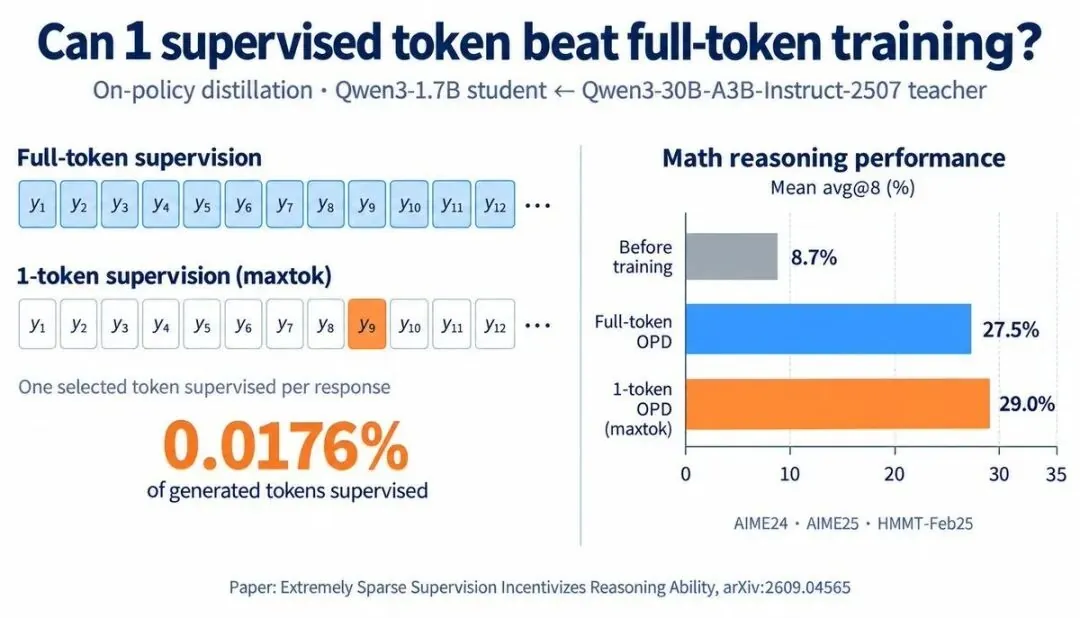
亞馬遜與杜克大學研究發現,提升大模型數學推理能力未必需在整條推理軌跡上密集訓練,僅對單個關鍵token施加訓練信號即可顯著提升性能,甚至超越全軌跡訓練。發現挑戰密集監督的傳統認知,為後訓練開闢新路。
直覺與現實的落差
大模型解一道數學題,往往需要生成數千個token的推理過程。直覺上,要提升推理能力,須在大量token上施加訓練信號,透過整條軌跡的密集更新讓模型逐步變強。
IXThinker 會員內容
呢篇係 Archive 內容。登入即可解鎖全文,仲有成個 15,000+ 篇、每日更新嘅 AI 動態資料庫。
免費登入/註冊解鎖全文 →Google 或電郵地址即可,即刻解鎖。