IXThinker·2026-10-29 00:00
新方法提升機械人集群從仿真到現實遷移能力
多機械人系統的控制策略設計長期受仿真與現實落差所限。一項刊於Science Robotics的研究提出,將結構約束嵌入策略學習可彌合該差距,並首次在真實機械人集群上完成系統性遷移與驗證。
仿真到現實的難題
強化學習為自動生成機械人集群控制策略提供了強大框架,但受仿真與現實之間的差距影響,其在物理多機械人系統的應用一直受到限制。
多智能體強化學習雖有顯著進展,基於梯度的仿真到現實遷移在物理機械人集群的系統性演示仍然罕見;大部分研究局限於仿真環境,少數實戰演示亦缺乏跨多次運行及跨任務的評估。
SwarmACB的設計
研究人員提出名為SwarmACB的方法,這是一種基於注意力機制的反事實策略梯度技術,專門用於機械人集群的行為選擇環節,屬該研究的核心方案。
SwarmACB屬多智能體Actor-Critic方法,機械人在預定義的行為模組之間進行仲裁,例子包括趨光性或聚集等反應性感覺運動程序。
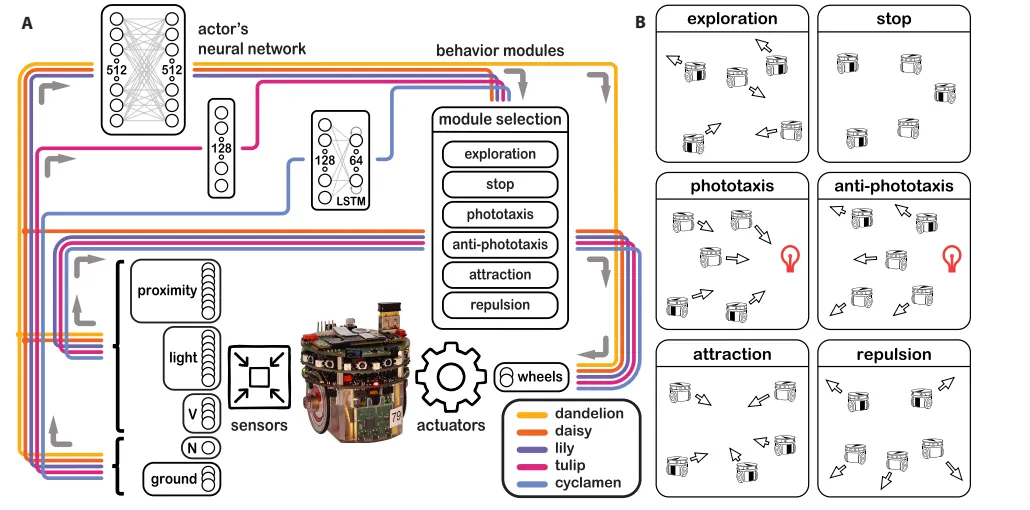
遷移與驗證成果
研究證明,通過將結構約束嵌入策略學習,可以克服仿真與現實的落差;該方法首次實現基於梯度的多智能體強化學習在真實機械人集群中的系統性遷移與驗證。
相較以往局限於仿真環境、或僅有缺乏系統評估的少數實戰演示,此次成果為多智能體強化學習在物理機械人集群的實際應用,提供了可對照的驗證基準。